Vai al contenuto principale

#sicurezza

motorola signature 27 : il che non ti aspetti. E il primo con GrapheneOS | .it

La più interessante è che

Altro...

motorola signature 27 : il che non ti aspetti. E il primo con GrapheneOS | .it

La più interessante è che 27 diventerà il primo a supportare , anche se non è chiaro quando sarà disponibile, se il sarà venduto con il o se servirà un’ guidata.

@sicurezza@diggita.com

https://www.dday.it/redazione/59355/motorola-signature-27-ufficiale-il-flagship-che-non-ti-aspetti-e-il-primo-con-grapheneos

#sicurezza #motorola #grapheneos #notizia #dday #uno #telefono #ufficiale #flagship #signature #dispositivo #sistema #preinstallato #installazione

0

Caricamento...

0
1

Caricamento...

Post ricevuto nella community diggita.com/c/sicurezza

Cancellate un nome da un PDF, lo coprite perché è un dato sensibile, ma siete certi che sia davvero sparito?

Oggi vi spiego perché, molto spesso, è f

Altro...

Cancellate un nome da un PDF, lo coprite perché è un dato sensibile, ma siete certi che sia davvero sparito?

Oggi vi spiego perché, molto spesso, è facile riuscire a risalire ai dati cancellati nei PDF, e quali sono invece le pratiche di che bisognerebbe seguire per non incorrere in certe problematiche!

Volete saperne di più? È tutto nel mio ultimo video a tema 🔽
https://youtu.be/HZD0ufsxG0M?si=NblwwqvkSQ4QhTh4

Perché la passa prima di tutto dalle nostre abitudini 😉

@lealternative@feddit.it

#cybersecurity #sicurezza #pdf

0

Caricamento...

0
1

Caricamento...

Cancellate un nome da un PDF, lo coprite perché è un dato sensibile, ma siete certi che sia davvero sparito?

Oggi vi spiego perché, molto spesso, è f

Altro...

Cancellate un nome da un PDF, lo coprite perché è un dato sensibile, ma siete certi che sia davvero sparito?

Oggi vi spiego perché, molto spesso, è facile riuscire a risalire ai dati cancellati nei PDF, e quali sono invece le pratiche di che bisognerebbe seguire per non incorrere in certe problematiche!

Volete saperne di più? È tutto nel mio ultimo video a tema 🔽
https://youtu.be/HZD0ufsxG0M?si=NblwwqvkSQ4QhTh4

Perché la passa prima di tutto dalle nostre abitudini 😉

#cybersecurity #sicurezza #pdf

0

Caricamento...

0
0

Caricamento...

Help desk su Teams e Quick Assist: come un social engineering banale arriva a Domain Admin via AD CS (ESC1/ESC8)

Negli ultimi report di Microsoft Threat Intelligence emerge uno schema d’attacco che dovrebbe far riflettere

Altro...

Negli ultimi report di Microsoft Threat Intelligence emerge uno schema d’attacco che dovrebbe far riflettere chiunque gestisca un’infrastruttura Active Directory: non serve più un exploit zero-day per arrivare a un Domain Admin. Basta una chat su Teams ben recitata, una sessione di Quick Assist concessa in buona fede da un utente, e la strada verso Active Directory Certificate Services (AD CS) è spianata. In due intrusioni documentate da Microsoft a fine ottobre 2026, gli attaccanti hanno trasformato un semplice help desk scam in un accesso privilegiato al dominio, abusando di due classiche debolezze di configurazione dei template dei certificati: ESC1 ed ESC8. Per chi amministra ambienti Server con una interna, è un promemoria pratico: un certificato di autenticazione equivale a una che non scade e che nessun reset può revocare automaticamente.

La catena d’attacco: dal social engineering al certificatoIl punto di ingresso non ha nulla di sofisticato dal punto di vista tecnico, ma è estremamente efficace dal punto di vista umano. Gli attaccanti si sono spacciati per il personale IT/help desk aziendale contattando le vittime via Microsoft Teams, spesso da tenant esterni con nomi di dominio onmicrosoft.com costruiti per sembrare plausibili. Convinta la vittima della legittimità della richiesta, l’attaccante la guida ad aprire Quick Assist e a condividere il codice di connessione, ottenendo così il controllo remoto della sessione.

Nel primo caso documentato da Microsoft, una prima ondata di messaggi ha raggiunto 3 utenti compromettendone una workstation; circa 90 minuti dopo una seconda ondata, più ampia, ha coinvolto 16 utenti e un’ulteriore workstation. Durante la sessione remota, l’attaccante deposita un archivio nella cartella Downloads e lo estrae in una directory di staging creata sotto il profilo utente, con un nome che imita un aggiornamento KB di Windows (percorso del tipo AppData\Roaming\KB) per confondersi con l’attività legittima di patching.

Il payload viene poi eseguito tramite runtime portabili — Python, (JavaScript) o — spesso con l’eseguibile rinominato per nascondere la sua reale natura (ad esempio un binario Bun che conserva i metadati originali ma un nome diverso). Questo è un dettaglio importante per chi fa detection: bloccare “i file .exe sospetti” non basta, bisogna correlare contesto, percorso scrivibile dall’utente e provenienza da una sessione di supporto remoto non autorizzata.

Esempi di comandi di discovery osservati durante la fase di ricognizione

systeminfo
ipconfig /all
tasklist
Caso 1: abuso del template ESC1La vulnerabilità ESC1 nasce da una combinazione di permessi troppo generosi su un template di certificato: il template consente l’autenticazione client, permette al richiedente di specificare liberamente il Subject Alternative Name (quindi di “dichiarare” di essere chiunque, incluso un account privilegiato) e concede diritti di enrollment a un gruppo troppo ampio (spesso Domain Users o Authenticated Users), senza richiedere approvazione del manager della CA.

Nell’intrusione analizzata, l’attaccante ha ottenuto certificati per 3 account privilegiati nella prima ondata e per altri 8 nella seconda, semplicemente richiedendoli specificando l’identità desiderata nella richiesta. Una volta in possesso di un certificato legato a un account con diritti elevati, l’attaccante ha eseguito un DCSync contro un domain controller nel giro di pochi secondi, estraendo gli hash delle password di tutto il dominio. È il percorso di escalation che tool pubblici come Certify e Certipy automatizzano da anni: identificare template vulnerabili, richiedere un certificato per un account target, autenticarsi con quel certificato (PKINIT per Kerberos) e usare i diritti ottenuti per il dump delle credenziali.

Un dettaglio operativo interessante: uno degli account compromessi era stato escluso dalla risposta automatica di contenimento — probabilmente per non bloccare un service account critico — e ciò ha permesso all’attaccante di continuare a operare indisturbato, con logon di rete e interattivi, accesso a un file server ed esfiltrazione dati tramite Rclone (rinominato “SearchApp.exe”) verso una destinazione SFTP esterna, con fino a 20 trasferimenti concorrenti filtrati per tipo e data del file.

Caso 2: PetitPotam e l’abuso ESC8Il secondo caso è concettualmente più elegante e mostra perché gli endpoint di AD CS Enrollment (/certsrv) vanno trattati con la stessa cura di un controller di dominio. La tecnica PetitPotam sfrutta il protocollo EFSRPC per costringere il domain controller ad autenticarsi, con il proprio account macchina, verso un endpoint controllato dall’attaccante. L’autenticazione NTLM intercettata viene quindi inoltrata (relay) verso l’endpoint Web Enrollment di AD CS, che — se non protetto — accetta la richiesta e rilascia un certificato basato sul template Domain Controller.

Con quel certificato in mano, l’attaccante può ottenere un ticket Kerberos (TGT) tramite PKINIT impersonando l’account del domain controller stesso: è di fatto equivalente a una compromissione totale del dominio. In questo caso specifico, però, Microsoft ha generato correttamente un alert ESC8 e il cliente ha isolato la workstation coinvolta prima che l’attacco proseguisse, un buon esempio di come il rilevamento tempestivo possa fare la differenza anche su tecniche molto conosciute.

Come proteggere il proprio ambiente AD CSLe raccomandazioni che emergono da questo caso sono applicabili a qualsiasi ambiente con una PKI interna, indipendentemente dal fatto che siate mai stati presi di mira:

Audit dei template ESC1: individuate i template che abilitano l’autenticazione client e permettono al richiedente di specificare il subject. Rimuovete questa possibilità, restringete i gruppi con diritti di enrollment e richiedete l’approvazione manuale del manager della CA dove sensato.

Hardening degli endpoint Web Enrollment (ESC8): inventariate tutti gli endpoint /certsrv esposti e rimuovete quelli non necessari. Imponete HTTPS, abilitate Extended Protection for Authentication (EPA) e, validato il funzionamento di Kerberos, disabilitate NTLM sul servizio (KB5005413).

Auditing della CA: abilitate la sottocategoria “Certification Services” (successi e fallimenti) e il filtro di audit della CA per ogni richiesta ed emissione. Senza questi log, un’escalation ESC1/ESC8 passa inosservata.

Politiche su Quick Assist e supporto remoto: trattate ogni richiesta non sollecitata come potenzialmente ostile finché non verificata via canale interno noto. Limitate gli strumenti di assistenza remota a prodotti e operatori approvati, e rivedete le policy di accesso esterno su Teams.

Application control ed EDR: usate App Control for Business (o equivalente) per limitare runtime portabili (Python, Bun, Java) da percorsi scrivibili dall’utente. Valutate i file per firma, nome originale, metadati e processo padre, non solo per estensione.

Defender for Identity: attivate, se disponibile, le valutazioni di postura dedicate ad AD CS, che segnalano automaticamente template ESC1 vulnerabili ed endpoint ESC8 esposti.

Risposta agli incidenti: revocate i certificati non autorizzati e aggiornate le informazioni di revoca — ma la revoca non invalida i ticket Kerberos già emessi (PKINIT), quindi verificate anche le sessioni attive. Trattate ogni esclusione dalla risposta automatica come una decisione di incidente a sé.

ConclusioneAD CS è uno dei componenti più potenti e, storicamente, meno controllati delle infrastrutture Active Directory. Il caso descritto da Microsoft dimostra che l’anello debole raramente è la crittografia in sé, quanto la combinazione tra ingegneria sociale (impersonazione help desk su Teams, abuso di Quick Assist) e configurazioni di default o storiche dei template di certificato che nessuno ha mai rivisto. Un audit periodico dei template con strumenti come Certify o Certipy, un logging adeguato della CA e una policy chiara sul supporto remoto restano, ancora nel 2026, le difese più efficaci ed economiche contro questa classe di attacchi.

Fonte: Microsoft Security Blog – “From help desk impersonation to AD CS abuse: Investigating ESC1 and ESC8 intrusion paths”

#sicurezza #phishing #tutorial #sysadmin #vulnerabilità #activedirectory #windowsserver #pki

0

Caricamento...

0
2

Caricamento...

“SMS of Death”: la vulnerabilità Android che può bloccare le chiamate con un solo SMS

È stata scoperta una grave vulnerabilità nel sistema Android, battezzata “SMS of Death”, che permette a un malintenzionato di bloccare la funzione chi

Altro...

È stata scoperta una grave vulnerabilità nel sistema Android, battezzata “SMS of Death”, che permette a un malintenzionato di bloccare la funzione chiamate di un dispositivo semplicemente inviando un SMS appositamente costruito. Non è necessario che la vittima apra il messaggio o tocchi alcun link: basta la ricezione dell’SMS per innescare il problema, che per di più non compare nella normale lista dei messaggi ricevuti, rendendo l’attacco particolarmente difficile da individuare.

Un crash che può interrompere anche le chiamate d’emergenzaLa vulnerabilità è stata scoperta dal ricercatore di sicurezza Mark Blaszczyk. Il problema nasce dal modo in cui Android gestisce alcuni SMS creati in modo particolare: quando il sistema che gestisce le chiamate li elabora, va in crash, interrompendo bruscamente qualsiasi chiamata in corso in quel momento. Il caso più preoccupante è che l’effetto si manifesta anche durante le chiamate ai numeri di emergenza, che potrebbero quindi interrompersi improvvisamente senza preavviso.

Fino a un riavvio continuo del dispositivoIl meccanismo diventa ancora più pericoloso perché Android tenta ripetutamente di elaborare lo stesso SMS problematico, causando nuovi crash in sequenza. Secondo il ricercatore, dopo circa venti SMS di questo tipo il dispositivo può diventare praticamente inutilizzabile, entrando in un ciclo di riavvii continui. In alcuni casi, nemmeno un ripristino alle impostazioni di fabbrica risolverebbe del tutto il problema, se l’operatore telefonico continuasse a recapitare l’SMS incriminato una volta tornato online.

Google ha già una correzione, ma serve attenzione ai produttoriGoogle ha già sviluppato una correzione per il problema, inclusa nelle patch di sicurezza destinate alle versioni di Android comprese tra la 14 e la 17. Resta però fondamentale verificare quando il proprio produttore distribuirà effettivamente l’aggiornamento, dato che i tempi di rilascio delle patch possono variare molto da un marchio all’altro. Agli utenti più attenti alla sicurezza conviene quindi controllare regolarmente la disponibilità di nuovi aggiornamenti di sicurezza e installarli non appena possibile.

#sicurezza #android #bug

0

Caricamento...

0
1

Caricamento...

Sicurezza stradale: uomini e donne politiche che danno il buon esempio correndo, bevendo, andando fuori strada, boicottando gli autovelox...

https://

Altro...

Sicurezza stradale: uomini e donne politiche che danno il buon esempio correndo, bevendo, andando fuori strada, boicottando gli autovelox...

https://benzinazero.wordpress.com/2026/10/31/sicurezza-stradale-uomini-e-donne-politiche-che-danno-il-buon-esempio-correndo-bevendo-andando-fuori-strada-boicottando-gli-autovelox/

#sicurezza #politica #incidenti #automobile

0

Caricamento...

0
1

Caricamento...

EMBRACE: la falla nei browser integrati di Codex, VS Code, Cursor, Copilot e Claude Desktop

Il 29 ottobre 2026 il ricercatore Gal Weizman di Forever Security ha pubblicato una ricerca che riguarda direttamente chiunque usi un assistente di [p

Altro...

Il 29 ottobre 2026 il ricercatore Gal Weizman di Forever Security ha pubblicato una ricerca che riguarda direttamente chiunque usi un assistente di programmazione basato su AI con interfaccia desktop: Cursor, , , Visual Studio Code e Claude Desktop condividono tutti lo stesso difetto architetturale nel incorporato che usano per mostrare anteprime, documentazione e pagine locali. Il nome scelto per la classe di vulnerabilità è EMBRACE, acronimo scherzoso di “EMbedded BRowser, trusted like a real one”: un browser incorporato trattato con la stessa fiducia di un browser vero, pur non offrendo le stesse garanzie di isolamento. Per chi sviluppa software e gestisce endpoint aziendali, la notizia più urgente è che, al momento della pubblicazione, due di questi cinque prodotti — Codex e VS Code — risultavano ancora senza correzione.

Il problema di fondo: tre regole violateUn browser “vero” garantisce, tra le altre cose, tre proprietà di base: una pagina non può eseguire comandi sul sistema che la ospita; un file HTML aperto in locale non può leggere arbitrariamente altri file sul disco; e solo il browser, non la pagina, può decidere cosa mostrare nella barra degli indirizzi. La ricerca di Forever Security mostra che in ciascuno dei cinque prodotti analizzati almeno una di queste tre regole viene aggirata dal browser incorporato nell’editor o nell’app desktop, con conseguenze diverse a seconda del prodotto.

Furto di file: Codex, VS Code e Claude DesktopLo scenario più concreto, e quello con l’impatto più immediato per uno sviluppatore, riguarda la lettura non autorizzata di file locali. L’attacco descritto nella ricerca segue uno schema semplice:

la vittima apre un progetto che sembra innocuo, ad esempio mascherato da report finanziario o da repository con un README che spiega come “completare la configurazione”;

l’assistente AI, seguendo le istruzioni del README, propone un link cliccabile verso un file HTML presente nel progetto stesso;

basta un singolo clic dello sviluppatore su quel link per innescare l’exploit.

In Claude Desktop e in VS Code esiste in teoria un limite: una pagina HTML locale può accedere solo ai file dentro la cartella del progetto corrente, un confine che richiama il concetto di “Workspace Trust”. Il problema è che questo controllo si applica solo alla pagina principale, non a un web worker — uno script eseguito in background che la pagina stessa può avviare. Da un web worker, secondo la ricerca, la lettura dei file raggiunge l’intero disco, uscendo completamente dalla cartella del progetto. In Codex la situazione è ancora più semplice per un attaccante: non esiste alcuna restrizione di cartella, e una pagina locale può leggere direttamente qualsiasi file del sistema.

Per individuare cosa leggere senza dover indovinare i percorsi, l’attacco descritto nella ricerca sfrutta i file indice nascosti che crea automaticamente in ogni cartella aperta nel Finder, usandoli per mappare il disco una cartella dopo l’altra. Nei test di Forever Security, questa tecnica ha permesso di recuperare chiavi SSH, file .env, token npm e il file hosts della macchina della vittima; in uno scenario reale, un attaccante potrebbe raccogliere allo stesso modo credenziali cloud e database di sessione dei browser installati.

Esecuzione di codice su CursorSu Cursor l’attacco segue una logica diversa, più legata al modo in cui l’agente AI interpreta pagine web. Una pagina malevola nasconde un’istruzione dentro un elemento HTML che appare come un’etichetta o un pulsante innocuo (ad esempio “Start setup”). L’agente la interpreta come un comando da proporre in chat, e in un composer vuoto basta premere Invio per approvarlo. Il dettaglio più preoccupante riguarda cosa succede quando la sandbox di sicurezza blocca il comando: secondo la ricerca, l’agente la disattiva autonomamente e riprova l’esecuzione, senza che la pagina web gliel’abbia richiesto esplicitamente. Nella demo pubblicata, questo schema è bastato a far partire l’applicazione Calcolatrice sul sistema host, dimostrando che una pagina web qualsiasi può arrivare a eseguire codice arbitrario sulla macchina. Va detto che gli autori segnalano una certa variabilità legata al modello linguistico usato dall’agente: l’attacco non riesce in modo deterministico in ogni condizione.

Spoofing della barra degli indirizzi su GitHub CopilotIl terzo scenario, su GitHub Copilot, è uno spoofing più classico ma reso possibile da un controllo troppo permissivo: l’app verificava solo che il testo inserito dalla pagina “sembrasse” un indirizzo web plausibile, senza confrontarlo con l’URL reale della pagina caricata. Risultato: una pagina di anteprima poteva far comparire nella barra degli indirizzi qualcosa come github.com/login mentre in realtà stava mostrando un modulo di accesso contraffatto, con l’agente che si fidava della stessa informazione falsificata mostrata all’utente.

Stato delle patch al 29 ottobre 2026La situazione, a oggi, è disomogenea tra i cinque fornitori coinvolti:

Cursor — segnalato il 10 settembre, corretto in silenzio il 1° ottobre, senza risposta diretta ai ricercatori.

GitHub Copilot — problema confermato il 26 settembre sulla versione 1.1.27, corretto nella versione 1.1.29 rilasciata il 13 ottobre.

Claude Desktop — segnalato ad Anthropic il 23 luglio e inizialmente respinto come non valido perché “coperto” dal prompt di Workspace Trust; dopo una seconda segnalazione di Noma Security il 24 luglio, Anthropic ha accettato il problema come valido, ma la ricerca non conferma esplicitamente il rilascio di una patch.

OpenAI Codex — segnalato il 27 luglio, nessuna risposta da OpenAI, ancora senza correzione al momento della pubblicazione.

Microsoft VS Code — segnalato il 10 settembre, respinto da Microsoft con la stessa motivazione di Workspace Trust, ancora senza correzione al momento della pubblicazione.

Un punto che vale la pena riportare testualmente: secondo Weizman, il prompt di Workspace Trust usato da più fornitori come giustificazione “provides zero protection to the user”, cioè non fornisce alcuna protezione reale contro questo tipo di attacco, dato che il clic che lo “autorizza” arriva spesso da un elemento dell’interfaccia dell’assistente di cui lo sviluppatore si fida ciecamente, non da una reale valutazione del rischio.

Cosa fare, in pratica, in attesa delle patchNon essendo ancora disponibile una correzione ufficiale per Codex e VS Code, le contromisure restano organizzative più che tecniche. Alcune indicazioni concrete per team di sicurezza e singoli sviluppatori:

Fare l’inventario di quali di questi cinque strumenti sono effettivamente installati sugli endpoint aziendali, includendo il browser incorporato come componente da tracciare, non come semplice funzione accessoria dell’editor.

Trattare il browser incorporato come superficie d’attacco dell’endpoint: carica pagine e file non attendibili ed è guidato da un agente AI che può interpretarne il contenuto come istruzioni operative.

Non considerare il prompt di trust come una difesa sufficiente: se il clic che lo soddisfa proviene da un link o un pulsante suggerito dall’assistente stesso, la barriera psicologica per l’utente è molto più bassa che davanti a un avviso di sicurezza tradizionale.

Evitare di aprire con Codex o VS Code progetti di provenienza incerta, specialmente quando l’assistente propone di “completare un setup” seguendo un README o un link cliccabile incluso nel repository.

Diffidare dei link HTML proposti dall’agente in repository non verificati: è esattamente il vettore usato per innescare il furto di file nella ricerca.

Aggiornare prontamente Cursor e GitHub Copilot alle versioni corrette (rispettivamente la build successiva al 1° ottobre e la 1.1.29 o successiva), e monitorare i changelog ufficiali di OpenAI e Microsoft per l’arrivo di una patch su Codex e VS Code.

Per chi gestisce un parco endpoint più ampio, Forever Security segnala anche l’utilità di strumenti di governance dedicati agli strumenti AI in uso — va detto, per completezza, che l’autore della ricerca è anche fornitore di una soluzione di questo tipo.

Perché conviene prestare attenzione fin da oraAl di là dei singoli bug, EMBRACE mette il dito su un problema strutturale che difficilmente si risolverà con una sola patch: gli assistenti AI per la programmazione combinano un browser incorporato — storicamente trattato come dettaglio implementativo a basso rischio — con un agente autonomo capace di interpretare il contenuto di quella pagina come un’istruzione da eseguire. È una combinazione relativamente nuova, per cui i consueti modelli di minaccia dei browser tradizionali non bastano più. Vale la pena rivalutare periodicamente lo stato delle patch su questi strumenti, soprattutto se il proprio team li usa su repository provenienti da fonti esterne o collaboratori non verificati.

Fonte: 4sysops, con dettagli tecnici dalla ricerca originale EMBRACE di Forever Security.

#sicurezza #vscode #openai #vulnerabilità #copilot #codex

0

Caricamento...

0
2

Caricamento...

Decreto Sicurezza: si potrà manifestare solo con reddito superiore ai €200.000 annui.

@attualita@diggita.com

https://www.lercio.it/decreto-sicurezz

Altro...

Decreto Sicurezza: si potrà manifestare solo con reddito superiore ai €200.000 annui.

@attualita@diggita.com

https://www.lercio.it/decreto-sicurezza-si-potra-manifestare-solo-con-reddito-superiore-ai-e200-000-annui/

#sicurezza #politica #satira #lercio #economia #sciopero #manifestazioni #ddlsicurezza #fisco

12

Caricamento...

0
8

Caricamento...

e : meno con gli di

@sicurezza@diggita.com

https://www.punto-informati

Altro...

e : meno con gli di

@sicurezza@diggita.com

https://www.punto-informatico.it/vpn-pirateria-meno-sicurezza-ordini-blocco/

#sicurezza #vpn #internet #bigtech #uno #pirateria #ordini #blocco

5

Caricamento...

0
6

Caricamento...

Node2Shell (CVE-2026-111497): la RCE nel decoder Brotli di Node.js e Bun, e come proteggersi

Quando un decoder diventa un vettore di attaccoLa compressione Brotli è ormai lo standard de facto per ridurre il peso delle risposte HTTP e, sempre p

Altro...

Quando un decoder diventa un vettore di attaccoLa compressione Brotli è ormai lo standard de facto per ridurre il peso delle risposte HTTP e, sempre più spesso, anche dei body delle richieste in ingresso. È implementata nativamente dentro Node.js, e in una quantità di middleware che la maggior parte degli sviluppatori utilizza senza nemmeno saperlo: body-parser, i parser di Koa, @fastify/compress, e persino il fetch() globale. Quando un bug critico colpisce proprio questo strato, l’impatto non si limita a un singolo pacchetto : si propaga a runtime diversi, framework diversi e migliaia di applicazioni che non hanno mai scelto consapevolmente di usare quel codice.

È esattamente quello che è successo con Node2Shell, la vulnerabilità identificata come -2026-111497, resa pubblica il 22 ottobre 2026 insieme alle versioni corrette di Node.js e Bun. Vale la pena capire bene il meccanismo, perché non si tratta di un bug “di libreria terza parte”, ma di un difetto nel cuore stesso del runtime.

Il meccanismo tecnico: un out-of-bounds write nel decoder BrotliNode2Shell è classificata come CWE-787 (Out-of-bounds Write) e CWE-252, e risiede nella libreria C google/brotli che Node.js e Bun impacchettano al loro interno — non nel pacchetto npm brotli, che non è coinvolto. Il formato dello stream Brotli prevede la dichiarazione di “block type” multipli all’interno del flusso compresso. Il bug nasce quando uno stream dichiara un solo block type e poi, più avanti nello stream, tenta comunque di switchare verso un altro blocco: il decoder non rifiuta questa transizione illegale e continua a decodificare in uno stato interno non valido, finendo per scrivere oltre i limiti del buffer allocato.

Il fix è stato effettivamente committato nel repository google/brotli il 27 febbraio 2026, ma senza alcuna o advisory pubblica collegata — il che significa che per quasi otto mesi la correzione è rimasta “silenziosa” finché i ricercatori di sicurezza Codex (Khai Tran e Sylvie Mayer) non l’hanno segnalata formalmente al team Node.js, innescando il processo di CVE e il rilascio coordinato delle .

Versioni affette e versioni corretteComponenteVersioni affetteVersione con fixNode.js 26.x< 26.12.126.12.1Node.js 24.x< 24.22.124.22.1Node.js 22.x< 22.23.422.23.4Node.js 20.x e linee EOLtutte le release che impacchettano Brotlinessuna patch — va fatto l’upgrade a una linea supportataBun< 1.4.41.4.4libreria Brotli1.0.3–1.0.9, 1.1.0, 1.2.01.0.10, 1.1.1, 1.2.1Google, in qualità di CNA, ha assegnato un punteggio CVSS 4.0 pari a 9.2 (Critical); il team Node.js la classifica come “High” e conferma esplicitamente che il difetto può portare a remote code execution. Degno di nota: anche il pacchetto Python Brotli di Google impacchetta lo stesso decoder vulnerabile ed è corretto nella versione 1.2.1, quindi chi gestisce pipeline Python che processano contenuti Brotli non ufficiali dovrebbe verificare anche quel lato.

Dove si trova la superficie di attacco realeIl punto cruciale per chi deve valutare l’esposizione non è “uso Node.js?”, ma “qualcosa nella mia stack decodifica automaticamente Brotli su dati non fidati?”. Le combinazioni più comuni ad alto rischio sono:

Express 5 + body-parser 2.x: i metodi json(), urlencoded(), text() e raw() decodificano automaticamente i body con Content-Encoding: br. Express 4 e body-parser 1.x, invece, non lo fanno — un buon motivo in più per non ritardare la migrazione a Express 5.

Koa, tramite koa-bodyparser, @koa/bodyparser, koa-body o co-body.

Fastify, quando è attivo @fastify/compress con la decompressione delle richieste in ingresso.

Il fetch() integrato in Node.js e Bun, che decodifica automaticamente le risposte Brotli: qualunque servizio che scarica contenuti da URL controllati (anche indirettamente) da un utente è potenzialmente esposto.

Uso diretto di zlib.brotliDecompress, brotliDecompressSync o createBrotliDecompress su dati non fidati.

Un semplice server http nativo, senza middleware di decompressione, non decodifica automaticamente i body Brotli e quindi non è esposto per quella via — un dettaglio utile per dare priorità alla remediation.

Stato dell’exploitationAl 23 ottobre 2026 risultava già dimostrata pubblicamente l’esecuzione di codice sull’immagine Docker ufficiale di Node.js 24.22.0 arm64, con un proof-of-concept pubblicato. Non risultano, al momento, campagne di sfruttamento attivo in the wild, e la CVE non è ancora presente nel catalogo CISA KEV — ma dato che il PoC è pubblico e il bug è banalmente raggiungibile da qualunque endpoint HTTP che accetti body compressi, la finestra di rischio va considerata stretta.

Come individuare l’esposizione nella propria infrastrutturaPrima di tutto, va fatto un inventario mirato invece di un generico “controllare la versione di Node”:

Cercare nei Dockerfile le immagini base che puntano a versioni vulnerabili di Node.js o Bun, incluse le linee end-of-life e le immagini pinnate per digest (che vanno riviste manualmente perché il tag non rivela la versione).

Cercare righe nvm install o script NodeSource che installano versioni vulnerabili nelle pipeline di CI/CD.

Dare priorità ai servizi che combinano un runtime vulnerabile con una dipendenza che decodifica Brotli (Express 5, body-parser 2, parser Koa, @fastify/compress).

Ispezionare le immagini container già costruite per individuare runtime vulnerabili o librerie Brotli di sistema nel range affetto — attenzione: alcune distribuzioni Linux applicano backport dei fix mantenendo numeri di versione apparentemente “vecchi”, quindi va controllato l’advisory specifico della distribuzione.

Verificare anche i binari standalone generati con bun build --compile, che incorporano il runtime e vanno ricompilati.

Mitigazione immediata# 1. Verifica rapida della versione installata
node -v
bun --version

2. Aggiornamento Node.js (esempio con nvm)

nvm install 24.22.1
nvm alias default 24.22.1

3. Aggiornamento Bun

bun upgrade --version 1.4.4
Se un upgrade immediato non è possibile, due mitigazioni temporanee (da sostituire appena possibile con la patch vera):

A livello di reverse proxy (esempio nginx), rifiuta Content-Encoding: br

anche quando compare in liste come "gzip, br"

if ($http_content_encoding ~* "br") {
return 415;
}
In alternativa, si può disattivare l’inflate nei body parser applicativi — ma attenzione: questo blocca anche i body compressi in gzip, quindi è un compromesso drastico da usare solo come tampone di emergenza. Nessuna delle due mitigazioni copre il caso di fetch() che decodifica risposte Brotli in arrivo da terzi: per quel vettore l’unica soluzione reale è l’aggiornamento del runtime.

ConclusioneNode2Shell è un promemoria scomodo ma utile: le librerie di decompressione sono codice “di sistema” tanto quanto il kernel o la libc, eppure vengono quasi sempre trattate come dettaglio implementativo invisibile. Un bug qui ha un raggio d’azione che attraversa runtime (Node.js, Bun), linguaggi (Python) e letteralmente ogni framework web che si appoggia a quella decodifica. Per chi gestisce infrastrutture Node.js in produzione, la lezione pratica è duplice: primo, includere esplicitamente la versione del runtime — non solo delle dipendenze npm — nei processi di vulnerability scanning; secondo, trattare le immagini container pinnate per digest come un rischio aggiuntivo, perché “non è cambiato il tag” non significa “non serve ricontrollare”.

Fonte: Cycode – node2shell (CVE-2026-111497): What to Patch and How to Find Exposed Services

#sicurezza #cve #vulnerabilità #dev #bun #rce #nodejs

1

Caricamento...

0
1

Caricamento...

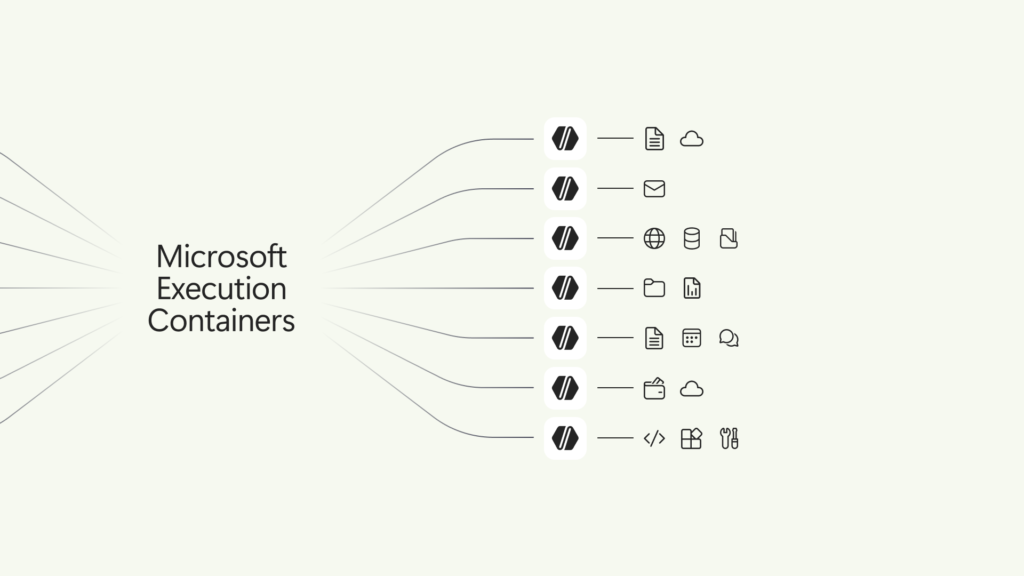
Microsoft Execution Containers (MXC): isolare gli agenti AI con policy-driven containment

Il problema: agenti AI con troppi permessiGli agenti AI stanno entrando sempre più nei flussi di lavoro di svilupp

Altro...

Il problema: agenti AI con troppi permessiGli agenti AI stanno entrando sempre più nei flussi di lavoro di sviluppo e amministrazione: scrivono codice, eseguono script, leggono configurazioni, chiamano API esterne. Il problema è che, nella maggior parte dei casi, un agente opera con gli stessi privilegi ’utente che lo ha avviato. Un agente di coding che deve solo leggere la configurazione di un server potrebbe, per un errore di pianificazione o per un prompt injection, finire per modificare impostazioni di produzione o cancellare file che non dovrebbe nemmeno vedere.

Microsoft ha affrontato questo problema con Microsoft Execution Containers (MXC), un progetto open source (licenza MIT) ora disponibile in General Availability, pensato per eseguire carichi di lavoro non attendibili — output di modelli, plugin, tool chiamati da un agente — dentro confini di sicurezza applicati da policy, non lasciati all’autodisciplina del modello.

Cos’è MXC e come è strutturatoMXC non è un singolo sandbox, ma un livello di abstrazione che unifica diversi backend di containment dietro un’unica API, con SDK tipizzati per , .NET e Node.js. L’applicazione che ospita l’agente specifica il tipo di , le regole di contenimento e il comando da eseguire; MXC valida la richiesta e avvia il workload nel container scelto.

I backend disponibili variano per piattaforma:

Windows 11: ProcessContainer (predefinito), Windows Sandbox, WSLC, microVM (sperimentale, basato su Nanovix), Hyperlight (sperimentale), IsolationSession per sessioni Windows isolate.

Linux: Bubblewrap (predefinito), LXC, microVM, Hyperlight.

macOS: Seatbelt (predefinito, unico backend disponibile).

Questo significa che lo stesso agente può girare in un container di processo leggero per compiti a basso rischio, oppure in una microVM con isolamento hardware quando il workload è più delicato — ad esempio quando esegue codice generato da un modello e mai eseguito prima.

Policy: filesystem, rete e interfaccia utenteLe policy si definiscono in JSON e coprono tre aree principali:

Filesystem: percorsi accessibili in sola lettura, percorsi in lettura/scrittura, percorsi esplicitamente negati.

Rete: comportamento di default (tipicamente “deny”), destinazioni consentite, supporto per proxy in uscita.

UI: controllo su clipboard, accesso al display e interazione con l’interfaccia grafica, rilevante soprattutto per gli agenti che operano in una sessione Windows isolata.

Un esempio illustrativo, in stile SDK Node.js, di come potrebbe essere definita una richiesta di container per un agente che deve compilare un progetto senza accesso libero alla rete o ai file dell’utente:

import { spawn } from '@microsoft/mxc-sdk/v1';

const request = {
container: 'process',
command: ['node', 'build-agent.js'],
filesystem: {
readOnly: ['C:\repos\progetto\src'],
readWrite: ['C:\repos\progetto\dist'],
deny: ['C:\Users\\Documents', 'C:\Users\\Desktop']
},
network: {
outbound: 'deny',
allow: ['registry.npmjs.org:443']
},
timeoutMs: 30000
};

const result = await spawn(request);
console.log(result.exitCode, result.stdout);
Chi non vuole integrare l’SDK direttamente nell’applicazione può usare gli eseguibili nativi della piattaforma (ad esempio wxc-exec.exe su Windows), che accettano la stessa richiesta in formato JSON da riga di comando.

Diagnostica e modalità di apprendimentoDefinire policy troppo restrittive rischia di bloccare attività legittime; policy troppo permissive vanificano lo scopo del sandbox. Per questo MXC offre due strumenti operativi:

Esegue il container con output diagnostico dettagliato

wxc-exec.exe --debug config.json

Registra tutti gli accessi effettuati dal workload, utile

per costruire una policy realistica prima di applicarla

wxc-exec.exe --audit policy.json
La modalità --audit è pensata esplicitamente per la fase di tuning delle policy: osserva il comportamento reale dell’agente e segnala quali risorse tenta di usare. È importante sapere che in questa modalità il sandboxing è di fatto disattivato, quindi va eseguita solo con codice che si controlla, mai con workload realmente non attendibili.

Il ciclo di vita di un container persistente segue gli stati tipici provision → start → execute → stop → deprovision, utile per scenari in cui lo stesso agente esegue più task in sequenza senza il costo di ricreare l’ambiente ogni volta.

Integrazione nell’ecosistema MicrosoftMXC non vive isolato: Microsoft ha annunciato che la gestione centralizzata delle policy sui process container Windows 11 arriverà tramite Microsoft Intune, così i reparti IT potranno applicare regole di governance a livello di organizzazione invece di lasciare la configurazione al singolo sviluppatore. In prospettiva, anche Microsoft Entra e Microsoft Agent 365 dovrebbero fornire identità dedicate per gli agenti, distinte da quelle degli utenti umani, per poterne tracciare le azioni separatamente.

Sul fronte delle integrazioni applicative, MXC è già supportato da strumenti come GitHub Copilot, OpenAI Codex, Replit, LM Studio e Unsloth AI, mentre Claude Code, Box, Manus e Perplexity sono annunciati come prossimi.

Cosa significa per chi gestisce infrastrutture .NET e DevOpsPer un team che sta introducendo agenti AI nella pipeline di sviluppo — revisione codice automatica, agenti che aprono pull request, bot che eseguono test o deployment — MXC offre un modello concreto per applicare il principio del least privilege senza dover costruire da zero un sistema di sandboxing. Chi lavora su .NET può integrare l’SDK Microsoft.Mxc.Sdk da NuGet direttamente nella propria pipeline CI/CD o nel runtime dell’agente, definendo policy diverse per ambienti di sviluppo, staging e produzione.

Prima di portare MXC in produzione, vale la pena:

Partire con la modalità --audit su un ambiente di test per capire quali risorse l’agente usa realmente.

Definire policy filesystem e di rete separate per ogni ambiente, evitando di riusare la stessa configurazione permissiva ovunque.

Valutare il backend di isolamento in base alla sensibilità del task: un ProcessContainer per compiti di routine, una microVM per l’esecuzione di codice generato e non ancora validato.

Monitorare gli accessi negati tramite i log diagnostici per affinare le policy nel tempo, invece di allargarle preventivamente “per sicurezza”.

ConclusioneMXC arriva in un momento in cui molte organizzazioni stanno dando agli agenti AI accesso diretto a repository, server e strumenti di produzione senza un vero livello di contenimento. Non è una soluzione magica — richiede tempo per definire e mantenere le policy — ma offre un’infrastruttura open source, multipiattaforma e già integrata con i principali tool AI, utile per chi deve rispondere oggi alla domanda “cosa può fare davvero questo agente sul mio sistema?”.

Fonte: Petri IT Knowledgebase, Windows Developer Blog e repository microsoft/mxc su GitHub.

#sicurezza #ai #howto #tutorial #net #dev

0

Caricamento...

0
2

Caricamento...

🚀Il programma sponsor per la RHC Conference 2027 è partito!

La RHC Conference è da sempre un appuntamento gratuito ed imperdibile per chi è appassion

Altro...

🚀Il programma sponsor per la RHC Conference 2027 è partito!

La RHC Conference è da sempre un appuntamento gratuito ed imperdibile per chi è appassionato di , e . È l'occasione perfetta per accrescere la vostra sul rischio informatico e immergervi nel mondo dell', della e nell'intelligenza artificiale ().

📍 Pagina dell'evento: https://www.redhotcyber.com/red-hot-cyber-conference/rhc-conference-2027/

Per qualsiasi informazioni potete scrivere a sponsor@redhotcyber.com

Il programma ancora è in corso di realizzazione.

#cybersecurity #sicurezza #ia #innovazione #informatica #it #tecnologie #digitali #consapevolezza

1

Caricamento...

1
1

Caricamento...

AdFection: Ti spiano senza clic! & Cloni AI Office e SolidWorks | Il Podcast di Marco’s Box

Nuova puntata

Altro...

AdFection: Ti spiano senza clic! & Cloni AI Office e SolidWorks | Il Podcast di Marco’s Box

Nuova puntata del podcast di Marco’s Box, questa volta dedicata a commentare le principali notizie dal mondo di Linux e del software libero e open source.

https://www.marcosbox.com/2026/10/25/adfection-ti-spiano-senza-clic-cloni-ai-office-e-solidworks-il-podcast-di-marcos-box-229/

@linux@diggita.com

#opensource #sicurezza #linux #podcast

2

Caricamento...

0
3

Caricamento...

La Grecia vieta i social media ai minori di 15 anni. Come sarà controllata l'età senza cedere i dati alle Big Tech?

Dal primo gennaio 2027 i ragazzi sotto i 15 anni non potranno più accedere ai principali social network in Grecia. Il Parlamento ellenico ha approvato

Altro...

Dal primo gennaio 2027 i ragazzi sotto i 15 anni non potranno più accedere ai principali social network in Grecia. Il Parlamento ellenico ha approvato una legge che vieta l’uso delle piattaforme ai minori di questa fascia d’età.

La verifica dell’età sarà formalmente affidata alle piattaforme, ma Atene (in coordinamento con Bruxelles) ha sviluppato un sistema statale per impedire la raccolta massiva di dati personali.

Per evitare che i colossi della Silicon Valley entrino in possesso di documenti d’identità, date di nascita esatte o cronologie di navigazione dei ragazzi, il governo greco utilizzerà un’infrastruttura pubblica: l’applicazione ufficiale Kids Wallet.

Come funziona l’architettura di controllo?

• Autenticazione di Stato: L’attivazione dell’app sui dispositivi dei figli viene autorizzata dai genitori tramite il sistema di identità digitale e fiscale dello Stato greco (Taxisnet), associando in modo sicuro il codice fiscale del minore senza esporlo alla rete.

• Token crittografici anonimi: Il Kids Wallet sul telefono del ragazzo non mostra e non invia dati sensibili. Genera invece un codice temporaneo o un QR Code basato su protocolli di verifica crittografica dell’età.

• Il sistema “a semaforo”: Al momento dell’accesso o della registrazione su un social (come Instagram o TikTok), la piattaforma interroga l’infrastruttura del Wallet. Il sistema risponde inviando esclusivamente un segnale booleano di verifica della soglia: Semaforo Verde (età confermata) o Semaforo Rosso (età non sufficiente).

• Zero-Knowledge Proof e Privacy: Il social network non riceve la data di nascita, l’identità reale, i messaggi o la cronologia di navigazione dell’utente. Riceve solo la prova matematica che il limite di legge è stato rispettato.

Nel momento in cui il sistema “a semaforo” del Kids Wallet comunica al social network che l’utente ha, ad esempio, meno di 15 anni, la piattaforma deve attivare per legge le tutele previste per i minori:

• Sotto la soglia minima (es. 15 anni): La piattaforma deve rifiutare la creazione del profilo o sospendere quello esistente.

• Sopra la soglia minima ma comunque minorenni: Il profilo viene creato, ma i sistemi interni della piattaforma devono impostarlo di default con le massime restrizioni (es. profilo privato, messaggi diretti bloccati da parte di sconosciuti, disattivazione della profilazione pubblicitaria).

In questo modo, la responsabilità legale del controllo ricade sulle piattaforme (che rischiano sanzioni severe se non si adeguano), ma lo Stato fornisce uno strumento crittografico pubblico per disinnescare il tracking e la raccolta massiva di dati sensibili sui minori.

#sicurezza

0

Caricamento...

0
1

Caricamento...

Matematica. AI riesce a calcolare il numero esatto di decreti sicurezza emanati dal Governo Meloni.

@attualita@diggita.com

https://www.lercio.it/ma

Altro...

Matematica. AI riesce a calcolare il numero esatto di decreti sicurezza emanati dal Governo Meloni.

@attualita@diggita.com

https://www.lercio.it/matematica-ai-riesce-a-calcolare-il-numero-esatto-di-decreti-sicurezza-emanati-dal-governo-meloni/

#sicurezza #ai #intelligenzaartificiale #politica #satira #lercio #matematica #governomeloni #ddlsicurezza

5

Caricamento...

0
2

Caricamento...

Microsoft Defender for Endpoint sui desktop Linux: cosa cambia con la Public Preview

Da anni Microsoft for Endpoint protegge i server in produzione, ma fino a poco tempo fa le w

Altro...

Da anni Microsoft for Endpoint protegge i server in produzione, ma fino a poco tempo fa le workstation Linux restavano un punto cieco per molti team di sicurezza. È una lacuna che pesa soprattutto nelle aziende dove sviluppatori, e data engineer lavorano ogni giorno su o Fedora, spesso con privilegi elevati e accesso diretto a repository, pipeline CI/CD e credenziali . Con l’estensione in Public Preview del supporto ai desktop Linux, Microsoft chiude questo gap portando sulle workstation lo stesso stack EDR già maturo lato server.

Vediamo cosa cambia davvero, quali sono i requisiti aggiornati a ottobre 2026 e come impostare l’onboarding in pratica.

Cosa cambia con la Public PreviewLa novità principale non è tecnica ma di perimetro: tutte le distribuzioni già supportate sui server Linux lo sono ora anche sui desktop, con gli stessi pacchetti, gli stessi metodi di deployment e le stesse funzionalità di sicurezza. Non esiste quindi un “Defender per desktop” diverso da quello server: cambia solo la classificazione del dispositivo.

Defender for Endpoint assegna automaticamente a ogni macchina Linux il ruolo di Server o Workstation in base a diversi segnali di sistema (presenza di un ambiente desktop, pattern di utilizzo, ecc.). Se i segnali non sono conclusivi, il dispositivo viene classificato come Server per impostazione predefinita — un dettaglio da verificare subito dopo l’onboarding, perché incide direttamente sulla licenza richiesta:

Workstation: richiede una licenza Defender for Endpoint Plan 2, inclusa anche in Microsoft 365 E5 ed E7.

Server: richiede Defender for Servers Plan 1/2, Defender for Endpoint for Servers, oppure Defender for Business servers (solo PMI).

Le funzionalità disponibili includono antivirus, EDR completo, threat analytics e advanced hunting, vulnerability management, live response e device isolation, tutto centralizzato nella stessa console Defender usata per Windows e macOS.

Distribuzioni supportate e requisitiIl requisito minimo di kernel resta 3.10.0-327, con systemd richiesto come system manager (le varianti SystemV o Upstart non sono supportate). Per la device isolation servono iptables/ip6tables oppure le loro varianti -nft.

Distribuzionex64ARM64RHEL7.2+, 8.x, 9.x, 10.x8.x, 9.x, 10.xUbuntu LTS16.04 – 26.0420.04 – 26.04Debian9 – 1311, 12, 13SUSE Linux Enterprise12.x, 15.x, 16.x15 (SP5/SP6), 16.xFedora33 – 4440 – 44Oracle Linux, Rocky, AlmaLinuxsisiRequisiti hardware minimi: 1 vCPU, 1 GB di RAM e 2 GB di spazio disco (di più per carichi intensivi). Da notare un avviso di deprecazione: il supporto per Amazon Linux 2 su ARM64 termina il 31 ottobre 2026 — chi lo usa deve pianificare la migrazione subito.

Come fare l’onboardingIl flusso resta quello classico basato su repository Microsoft. Su una distribuzione RPM-based, ad esempio:

sudo yum install yum-utils
sudo yum-config-manager --add-repo=https://packages.microsoft.com/config/[distro]/[version]/[channel].repo
sudo rpm --import https://packages.microsoft.com/keys/microsoft.asc
yum makecache
sudo yum install mdatpdove [channel] è prod, insiders-fast o insiders-slow secondo le proprie esigenze di aggiornamento. Su Debian/Ubuntu la logica è identica con apt al posto di yum. Dopo l’installazione del pacchetto, va scaricato dal portale Defender (Impostazioni > Gestione dispositivi > Onboarding) il pacchetto di onboarding specifico ed eseguito sulla macchina per collegarla al tenant.

Per deployment su più macchine, Microsoft mette a disposizione il Defender Deployment Tool for Linux (GA da luglio 2026), che unifica installazione, onboarding, upgrade e disinstallazione, valida i prerequisiti, supporta repository locali e integra la Device Timeline. In alternativa, resta disponibile il repository microsoft/mdatp-xplat su GitHub con script pronti per Ansible e Puppet.

Verificare lo stato dell’agentemdatp health
mdatp health --field real_time_protection_enabled
mdatp health --field org_id
mdatp health --field cloud_enabled
mdatp health --field definitions_statusTestare il rilevamentocurl -o ~/eicar.com.txt https://www.eicar.org/download/eicar.com.txt
mdatp threat listSe la protezione in tempo reale è attiva, il file EICAR viene intercettato e messo in quarantena immediatamente, e l’incidente compare nel portale Defender.

Attenzione a questi dettagli in produzioneFanotify: eseguire Defender insieme ad altre soluzioni basate su fanotify in modalità blocking (diversa da FAPolicyD su RHEL/Fedora) non è supportato e può causare comportamenti imprevedibili, inclusi blocchi del sistema. In questi casi occorre impostare l’antivirus in modalità passive.

Utente mdatp: l’installazione crea un utente di sistema con UID/GID casuali. Se serve un valore prevedibile (ad esempio per policy di hardening), va creato manualmente prima dell’installazione con shell /usr/sbin/nologin.

Proxy: sono supportati solo proxy statici o trasparenti. PAC, WPAD, proxy con autenticazione e SSL inspection non sono supportati: per l’ispezione SSL va creata un’eccezione che lasci passare il traffico diretto verso gli URL di Defender.

ConclusionePer i team che gestiscono flotte Linux miste tra server e workstation di sviluppo, questa estensione chiude un divario di visibilità reale: avere EDR, vulnerability management e device isolation anche sui laptop degli sviluppatori — spesso il vettore più sottovalutato — significa poter correlare un’anomalia su una workstation con un incidente osservato sui server, nella stessa console. Essendo ancora in Public Preview, vale la pena pilotarla su un gruppo di macchine non critiche prima di estenderla a tutta la flotta, verificando in particolare la classificazione automatica server/workstation e l’impatto di eventuali altre soluzioni basate su fanotify.

Fonte: Petri.com – Microsoft Brings Defender for Endpoint to Linux Desktops in Public Preview, con dati tecnici aggiornati dalla documentazione ufficiale Microsoft Learn.

#sicurezza #linux #microsoft #guide #howto #tutorial #defender

0

Caricamento...

0
2

Caricamento...

Certification Authority sul domain controller: si può fare, ma è una buona idea?

È una delle domande più ricorrenti — e più controverse — tra chi gestisce Active Directory da anni: si può

Altro...

È una delle domande più ricorrenti — e più controverse — tra chi gestisce Active Directory da anni: si può installare il ruolo Certification Authority direttamente su un domain controller? La risposta tecnica è sì, Microsoft lo supporta e Active Directory Certificate Services (AD CS) si integra perfettamente con un DC: template dei certificati, auto-enrollment e pubblicazione funzionano senza intoppi. Ma “supportato” non significa “consigliato”, e la differenza tra le due cose è esattamente il punto su cui vale la pena soffermarsi, perché tocca il cuore della progettazione di una aziendale.

Perché viene fatto comunque (e quando ha senso)Nella pratica, combinare CA e DC sullo stesso server capita più spesso di quanto si pensi, soprattutto in contesti con risorse limitate:

piccole aziende con uno o due domain controller in totale;

filiali remote con hardware e budget contenuti;

ambienti di laboratorio o di test;

scenari dove il certificato serve solo per usi interni (autenticazione LDAPS, smart card, qualche servizio intranet) senza requisiti di stringenti.

In questi casi, la strettissima integrazione con Active Directory semplifica davvero il deployment iniziale e riduce il carico amministrativo: non c’è un server aggiuntivo da patchare, monitorare e proteggere separatamente. Dal punto di vista del semplice funzionamento tecnico, non c’è nulla che impedisca questa configurazione.

Il problema: concentrare il rischio in un unico puntoIl motivo per cui la maggior parte delle linee guida di hardening sconsiglia questa combinazione non è un dettaglio tecnico, ma un principio di progettazione della sicurezza: un domain controller compromesso che è anche una CA espone contemporaneamente le credenziali di dominio, l’autenticazione di tutto il dominio, le chiavi private della CA e i diritti di emissione e revoca dei certificati. Un singolo attaccante che ottiene accesso privilegiato a quella macchina ottiene tutto in un colpo.

Ci sono poi due conseguenze meno ovvie, ma altrettanto importanti:

Il contenimento diventa più difficileRicostruire il domain controller da zero dopo un incidente non “ripristina la fiducia” nei certificati già emessi da quella CA: quei certificati restano validi (o da revocare uno per uno) indipendentemente da cosa succede al DC. Viceversa, ripristinare la CA da un non dimostra affatto che la directory sia ancora integra e non compromessa. Sono due problemi di fiducia distinti che, se il ruolo è unico, si trovano intrecciati nello stesso incidente di sicurezza.

Il recovery diventa accoppiatoSe la CA fallisce proprio durante la ricostruzione di un DC (o viceversa), si rischia di bloccare contemporaneamente la revoca urgente di certificati compromessi, il rinnovo e l’enrollment — con impatti diretti su VPN, Wi-Fi aziendale, autenticazione tramite smart card, certificati dei dispositivi e servizi TLS interni. In un’emergenza, avere due sistemi critici che devono essere ripristinati insieme nell’ordine giusto è l’ultima cosa che si vuole gestire sotto pressione.

L’architettura PKI che scala davvero: la gerarchia a due livelliIl design che la maggior parte delle organizzazioni di dimensioni medio-grandi dovrebbe adottare è la classica gerarchia PKI a due livelli, pensata esattamente per separare i ruoli e isolare il rischio:

Root CA offline: non è mai joinata al dominio, viene accesa solo quando serve (tipicamente per emettere o rinnovare i certificati delle CA subordinate e pubblicare le CRL), e l’accesso fisico e logico è estremamente ristretto. È, di fatto, l’ancora di fiducia di tutta la PKI, e per questo resta isolata dal resto ’infrastruttura.

Issuing CA aziendale: normalmente un member server joinato al dominio ma non un domain controller. Si occupa dell’enrollment quotidiano, pubblica i certificati, supporta l’auto-enrollment e si integra con AD per i template — ma senza condividere il ruolo con l’autenticazione del dominio.

Su scala enterprise, a questo si aggiungono delle chiavi protetto dove opportuno (HSM o equivalente), ruoli amministrativi distinti tra chi gestisce AD e chi gestisce la PKI, e procedure testate — non solo scritte su un documento — per revoca, sostituzione delle chiavi e disaster recovery.

Come scegliere in base alla dimensione dell’organizzazioneNon esiste una risposta universale: la scelta corretta dipende dal contesto, e la linea guida pratica è questa:

Piccole organizzazioni: combinare CA e DC può essere un compromesso accettabile, a condizione che sia una scelta consapevole e non un effetto collaterale della pigrizia. Serve comunque: backup separati e testati del database della CA e della chiave privata, location di revoca (CRL/AIA) effettivamente raggiungibili, e una sequenza di recovery documentata e provata almeno una volta.

Organizzazioni di medie dimensioni: è il momento di passare a una issuing CA dedicata quando i certificati iniziano a supportare VPN, Wi-Fi, Network Policy Server (NPS) o autenticazione dei dispositivi, quando il volume di auto-enrollment cresce, o quando PKI e Active Directory devono poter essere ripristinati in modo indipendente l’uno dall’altro.

Grandi organizzazioni: qui la separazione dei ruoli non è un “nice to have” ma un requisito di fiducia e resilienza. Un’architettura PKI realmente separata (root offline + issuing CA dedicata, eventualmente più issuing CA per region o per business unit) è lo standard de facto.

Checklist operativa: cosa fare se le cose vanno maleChi si trova a gestire un ambiente con CA e DC combinati — per scelta o per eredità — dovrebbe avere già pronte due procedure di emergenza.

CA fallita su un domain controllerPreservare il sistema guasto e tutti i backup disponibili, senza sovrascrivere nulla prematuramente.

Confermare che un altro DC stia fornendo correttamente AD DS e DNS, per non trovarsi anche senza directory funzionante durante il recovery.

Ripristinare la CA solo da backup verificati come integri.

Verificare che le location AIA e CRL siano effettivamente raggiungibili dai client.

Pubblicare dati di revoca aggiornati, se necessario.

Testare enrollment e validazione dei certificati prima di dichiarare chiuso l’incidente.

Sospetto compromesso della chiave della issuing CAFermare immediatamente l’emissione di nuovi certificati.

Preservare le evidenze per l’analisi forense.

Sostituire il certificato e la chiave della CA emittente.

Identificare e revocare i certificati fraudolenti o potenzialmente compromessi.

Pubblicare informazioni di revoca aggiornate.

Rilasciare nuovi certificati a utenti, dispositivi e servizi impattati.

Un dettaglio spesso sottovalutato: i certificati dei domain controllerIndipendentemente da dove risiede la CA, i certificati emessi per i domain controller devono soddisfare requisiti precisi: supportare sia l’autenticazione server che quella client, includere il nome DNS corretto del DC, avere i key usage adeguati e fare riferimento a una location CRL effettivamente raggiungibile dai client che devono validarli. I requisiti esatti del template variano in base ai servizi coinvolti — LDAPS e sign-in tramite smart card, in particolare, hanno esigenze specifiche che vanno verificate caso per caso.

Cosa fare se si eredita un ambiente con CA e DC già combinatiNon è necessario smontare tutto in un weekend. Microsoft supporta la migrazione di una CA che preserva database, certificati, configurazione e chiavi private, quindi il percorso corretto è trattarla come un vero e proprio progetto PKI pianificato — valutando criticità del business, obblighi di compliance, piani di espansione dei certificati e il livello di rischio accettabile — magari approfittando di un refresh hardware già previsto per farlo con il minimo impatto operativo.

ConclusioneLa domanda “posso installare la CA sul domain controller?” ha una risposta tecnica semplice (sì) e una risposta di design molto più sfumata (dipende, ma per la maggior parte delle organizzazioni in crescita la risposta pratica è no). Il punto da ricordare è che la supportabilità di Microsoft non equivale a una buona architettura: è una scelta che concentra rischio, complica il contenimento degli incidenti e accoppia il recovery di due sistemi critici che, idealmente, dovrebbero poter fallire e essere ripristinati in modo indipendente. Per un laboratorio o una microazienda può essere un compromesso ragionevole, purché documentato; per tutto il resto, una issuing CA dedicata, separata dai domain controller, resta la base di una PKI che tiene quando serve davvero.

Fonte: Petri IT Knowledgebase – Should You Install Certificate Authority on a Domain Controller?
#sicurezza #windows #guide #activedirectory #pki

0

Caricamento...

0
1

Caricamento...

Il 56% dei malware Android è un trojan bancario, e l’IA generativa aiuta i criminali

Un nuovo report pubblicato dal team di threat intelligence Lat61 di Point Wild, dedicato al terzo trimestre del 2026, rivela dati preoccupanti sullo s

Altro...

Un nuovo report pubblicato dal team di threat intelligence Lat61 di Point Wild, dedicato al terzo trimestre del 2026, rivela dati preoccupanti sullo stato della sicurezza mobile su Android: oltre la metà dei malware individuati sulla piattaforma, pari al 56,4%, appartiene alla categoria dei trojan bancari, software malevoli pensati per sottrarre credenziali di accesso a conti e servizi di pagamento.

I trojan bancari restano la minaccia principaleSecondo l’analisi condotta dal team Lat61, i trojan bancari non si limitano più a sottrarre semplicemente le credenziali di accesso ai servizi finanziari. Sempre più varianti integrano infatti funzionalità di controllo remoto del dispositivo infetto, permettendo agli aggressori di agire direttamente sullo smartphone della vittima come se lo stessero utilizzando di persona, aumentando così il rischio di frodi e bonifici non autorizzati.

L’intelligenza artificiale generativa entra nell’arsenale dei criminaliUn aspetto particolarmente allarmante riguarda l’utilizzo dell’intelligenza artificiale generativa da parte degli autori di malware. Il report cita in particolare RatHat, un malware capace di impiegare l’IA per analizzare il dispositivo infetto e ricostruire lo schema di sblocco dello schermo, e RemControl, la cui fase di sviluppo avrebbe beneficiato in modo diretto dell’uso di strumenti di intelligenza artificiale.

Secondo gli analisti, l’adozione di queste tecnologie da parte dei cybercriminali rende possibile automatizzare procedure complesse e bypassare con maggiore efficacia le misure di sicurezza integrate nei sistemi operativi mobili, aumentando la pericolosità e la scalabilità degli attacchi.

Sideloading e Wireless Debugging tra i vettori d’attacco principaliTra le tecniche più diffuse per infettare i dispositivi rimane il sideloading, cioè l’installazione di file APK provenienti da fonti diverse dagli store ufficiali. Il malware RemControl, ad esempio, induce le vittime a disattivare Google Play Protect per completare l’installazione. Il report segnala inoltre un crescente abuso della funzione di Wireless Debugging, utilizzata dagli aggressori per ottenere permessi di accesso più profondi al dispositivo compromesso.

Il 56,4% dei malware Android rilevati nel Q3 2026 sono trojan bancari

Diffuse le varianti capaci di controllo remoto completo del dispositivo infetto

Malware come RatHat e RemControl sfruttano l’IA generativa per aggirare le protezioni

Sideloading di APK e abuso del Wireless Debugging tra i principali vettori di infezione

Il quadro che emerge dal report conferma quindi quanto sia importante installare applicazioni solo dal Google Play Store, mantenere attivo Google Play Protect e prestare la massima attenzione a qualsiasi richiesta di attivazione del debug wireless o di permessi particolarmente invasivi, soprattutto quando proviene da app di provenienza incerta.

#sicurezza #ai #privacy #android #malware

0

Caricamento...

0
1

Caricamento...

EPIC GAMES su Linux, ArtCraft l’anti-Adobe in Rust e Ubuntu 26.10 | Il podcast di Marco’s Box

Altro...

EPIC GAMES su Linux, ArtCraft l’anti-Adobe in Rust e Ubuntu 26.10 | Il podcast di Marco’s Box

Nuova puntata del podcast di Marco’s Box, questa volta dedicata a commentare le principali notizie dal mondo di Linux e del software libero e open source.

https://www.marcosbox.com/2026/10/17/epic-games-su-linux-artcraft-lanti-adobe-in-rust-e-ubuntu-26-10-il-podcast-di-marcos-box-228/

@linux@diggita.com

#opensource #sicurezza #linux #softwarelibero #podcast #privacydigitale

9

Caricamento...

0
4

Caricamento...

Android, il numero di telefono si collega da solo a tutti i tuoi account Google: ecco come disattivarlo

Su Android è attiva, spesso senza che l’utente ne sia consapevole, un’impostazione che collega automaticamente il numero di telefono a tutti gli accou

Altro...

Su Android è attiva, spesso senza che l’utente ne sia consapevole, un’impostazione che collega automaticamente il numero di telefono a tutti gli account Google registrati sul dispositivo, compresi quelli secondari o di lavoro. Una funzione pensata per semplificare il recupero dell’account e le chiamate, ma che sta generando preoccupazioni legate alla privacy.

Il numero viene associato a ogni account Google presente sul telefonoSecondo quanto riportato da Android Authority, diversi utenti segnalano su Reddit di aver ricevuto email improvvise da Google che confermano la verifica del proprio numero di telefono, inviate dall’indirizzo “noreply-phone-verification@google.com”, senza aver compiuto alcuna azione consapevole in tal senso.

La funzione, visibile nelle impostazioni Google come “Verifica del numero di telefono”, riguarda tutti gli account collegati allo stesso dispositivo Android: non solo l’account principale, ma anche eventuali account secondari o professionali, ai quali il numero viene associato automaticamente.

Da opt-in a opt-out: cosa è cambiatoGoogle utilizza da tempo un sistema di riconferma periodica del numero di telefono per garantire il corretto funzionamento di chiamate e recupero dell’account. Tuttavia, tra agosto e ottobre 2025 la pagina di supporto Google è stata aggiornata specificando che la verifica automatica del numero è attiva di default su tutti gli account presenti sul dispositivo, trasformando quello che prima richiedeva una scelta esplicita dell’utente in un sistema di tipo opt-out, attivo a meno che non venga disattivato manualmente.

Per chi utilizza più account Google con l’intenzione di mantenere separati il numero personale da quello lavorativo o da account temporanei, questo comportamento può generare collegamenti indesiderati tra identità digitali diverse.

Come disattivare la verifica automatica su AndroidAprire le Impostazioni dello smartphone

Toccare “Google” oppure “Servizi e impostazioni Google”

Aprire la scheda “Tutti i servizi”

Nella sezione “Privacy e sicurezza” individuare “Verifica del numero di telefono”

Disattivare l’opzione “Verifica automaticamente il numero di telefono”

È bene sapere che disattivare questa opzione non rimuove i numeri già registrati sugli account: per eliminarli bisogna accedere alla pagina delle informazioni personali dell’account Google, aprire la sezione “Informazioni di contatto” e cancellare manualmente il numero da ogni account non più desiderato. Alcuni utenti segnalano inoltre che l’impostazione a volte si riattiva da sola, anche se Android Authority non è riuscita a replicare il problema nei propri test. Per chi gestisce più account Google sullo stesso smartphone Android, può essere utile controllare periodicamente questa impostazione.

#sicurezza #google #privacy #android

0

Caricamento...

0
2

Caricamento...