Vai al contenuto principale

#ia

Alle elezioni locali, gli elettori si oppongono ai data center. Diverse comunità puntano su limiti e moratorie per contenere la crescita delle infrast

Altro...

Alle elezioni locali, gli elettori si oppongono ai data center. Diverse comunità puntano su limiti e moratorie per contenere la crescita delle infrastrutture dedicate all’IA. Le preoccupazioni riguardano inquinamento, uso dell’acqua, bollette energetiche e protezione del territorio. Solo l’11% sarebbe favorevole alla costruzione di un data center per l’IA. @sicurezza@diggita.com
https://stateline.org/2026/11/04/voters-across-the-country-reject-data-centers/

#ia #usa #datacenter

0

Caricamento...

0
1

Caricamento...

È davvero finita per X11?
Linus Torvalds vuole la nel kernel Linux?
Ubuntu 26.10 è davvero la Distro del momento?
Gemini Argon batte davvero Opus

Altro...

È davvero finita per X11?
Linus Torvalds vuole la nel kernel Linux?
Ubuntu 26.10 è davvero la Distro del momento?
Gemini Argon batte davvero Opus 5.5?

Sono tante le novità approdate nel mondo , , e in questo Ottobre 2026. Vediamole tutte nel mio ultimissimo video 🔽
https://youtu.be/EnX_eHzynAc

@lealternative@feddit.it

#tech #linux #ai #ia #foss

3

Caricamento...

2
4

Caricamento...

📝 Daily report 📈

Here are today's most popular trending hashtags #⃣ on our website 🌐️:

, , , , , ,

Altro...

📝 Daily report 📈

Here are today's most popular trending hashtags #⃣ on our website 🌐️:

, , , , , ,

🔥 Stay tuned! 🔥

#ia #privacy #android #devops #freebsd #kubernetes #proton

0

Caricamento...

0
0

Caricamento...

È davvero finita per X11?
Linus Torvalds vuole la nel kernel Linux?
Ubuntu 26.10 è davvero la Distro del momento?
Gemini Argon batte davvero Opus

Altro...

È davvero finita per X11?
Linus Torvalds vuole la nel kernel Linux?
Ubuntu 26.10 è davvero la Distro del momento?
Gemini Argon batte davvero Opus 5.5?

Sono tante le novità approdate nel mondo , , e in questo Ottobre 2026. Vediamole tutte nel mio ultimissimo video 🔽
https://youtu.be/EnX_eHzynAc

@gnulinuxitalia@feddit.it

#tech #linux #ai #ia #foss

1

Caricamento...

0
5

Caricamento...

Day 2026 porta il libero in oltre 50 città italiane, tra comunità, laboratori e riflessioni sulla . Sul fronte pu

Altro...

Day 2026 porta il libero in oltre 50 città italiane, tra comunità, laboratori e riflessioni sulla . Sul fronte pubblico, la digitale resta frenata da competenze, standard e burocrazia. Nel frattempo, e diventano infrastrutture strategiche, potenziali bersagli in caso di guerra. In , infine, l’autonomia tecnologica dipende da , materie prime e capitali.

@informatica@feddit.it

https://bit.ly/4jXNqkH

#linux #ia #europa #software #digitale #datacenter #energia #sovranita #pa

5

Caricamento...

0
6

Caricamento...

🚀Il programma sponsor per la RHC Conference 2027 è partito!

La RHC Conference è da sempre un appuntamento gratuito ed imperdibile per chi è appassion

Altro...

🚀Il programma sponsor per la RHC Conference 2027 è partito!

La RHC Conference è da sempre un appuntamento gratuito ed imperdibile per chi è appassionato di , e . È l'occasione perfetta per accrescere la vostra sul rischio informatico e immergervi nel mondo dell', della e nell'intelligenza artificiale ().

📍 Pagina dell'evento: https://www.redhotcyber.com/red-hot-cyber-conference/rhc-conference-2027/

Per qualsiasi informazioni potete scrivere a sponsor@redhotcyber.com

Il programma ancora è in corso di realizzazione.

#cybersecurity #sicurezza #ia #innovazione #informatica #it #tecnologie #digitali #consapevolezza

1

Caricamento...

1
1

Caricamento...

Banalizzando (ma non troppo) Luciano , nel suo sempre affascinante modo di comunicare:

“L’ da risposte, serve chi fa le domande”

Mi chied

Altro...

Banalizzando (ma non troppo) Luciano , nel suo sempre affascinante modo di comunicare:

“L’ da risposte, serve chi fa le domande”

Mi chiedo, dunque e mi riferisco soprattutto a quelle persone stuzzicate dall’idea che non serva più studiare su libri o esercitarsi cercando una risposta esclusivamente in autonomia:

“come si impara a fare domande?”

@aitech@feddit.it

#ia #llm #floridi

3

Caricamento...

1
2

Caricamento...

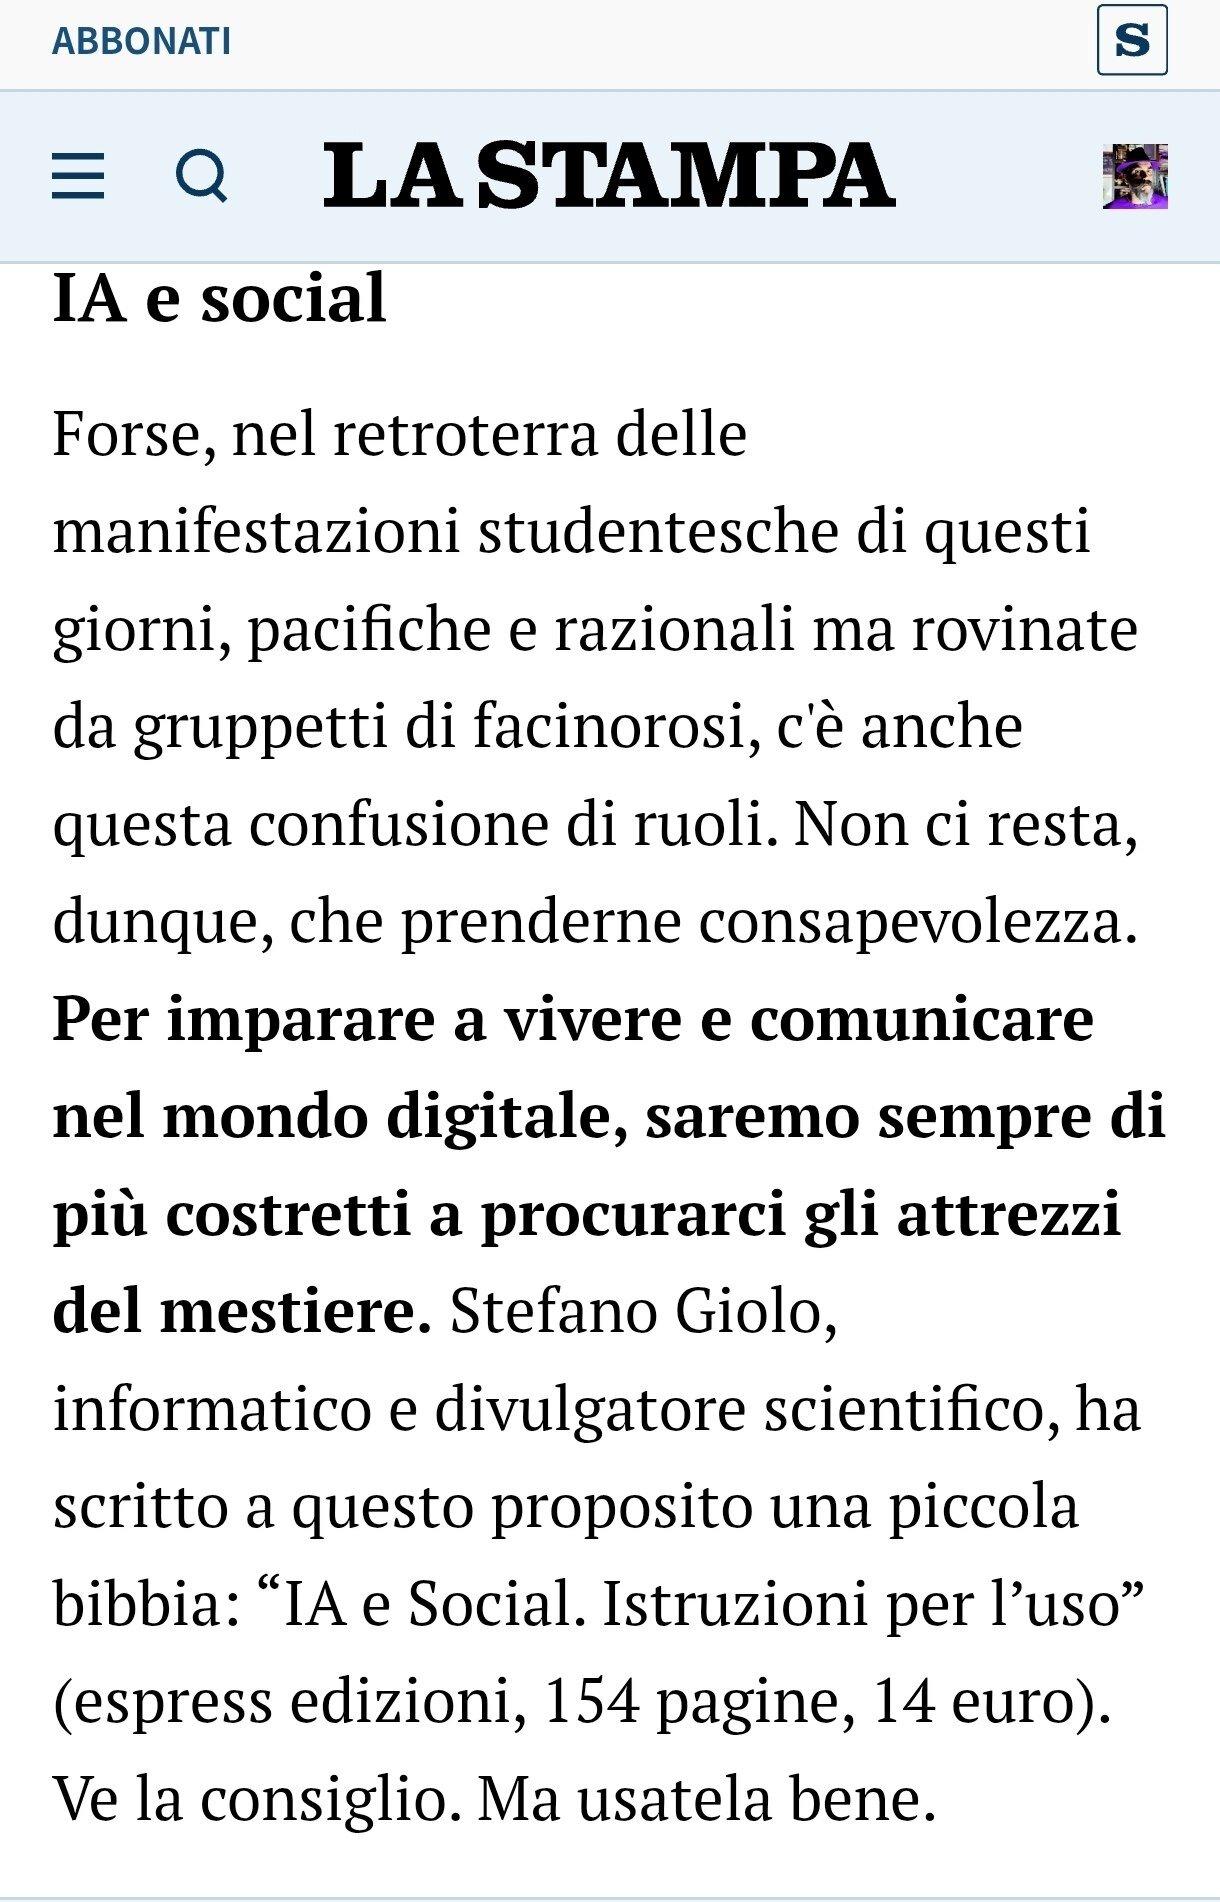
La Stampa consiglia il mio libro "Ia e Social, Istruzioni per l'uso"
La Stampa ha consigliato il mio libro "IA e Social, Istruzioni per l'uso" in un a

Altro...

La Stampa consiglia il mio libro "Ia e Social, Istruzioni per l'uso"
La Stampa ha consigliato il mio libro "IA e Social, Istruzioni per l'uso" in un articolo super interessante! Scopri di più su come l'intelligenza artificiale influisce sui social, vai a leggerlo! 📚🤖
@tecnologia@diggita.com

https://short.staipa.it/zmly7


#ia #socialmedia #lastampa

7

Caricamento...

0
4

Caricamento...

E se tutta questa corsa alla costruzione dei si spiegasse con la cara, vecchia speculazione edilizia?

https://www.rivistastudio.com/data-

Altro...

E se tutta questa corsa alla costruzione dei si spiegasse con la cara, vecchia speculazione edilizia?

https://www.rivistastudio.com/data-center-movimenti-protesta-italia/

Un'inchiesta di Federica Verona pubblicata sull'ultimo numero di Rivista Studio
"Aipocalypse Now" acquistabile qui: https://store.rivistastudio.com/prodotto/rivista-studio-n68/

L'articolo, segnalato stamattina da Loredana Lipperini a Pagina3 su Radio 3, si occupa soprattutto della proliferazione dei data center attorno a Milano e in Lombardia

Inchiesta approfondita e documentata con numerose interviste. Da leggere


@scuola@poliverso.org
@maupao@framapiaf.org
@RFanciola@social.vivaldi.net
@lindasartini@mastodon.uno
@milano@citiverse.it
@poliversity@poliverso.org
@lgsp@social.tchncs.de
@alephoto85@livellosegreto.it
@rivoluzioneurbanamobilita@poliversity.it
@fffitalia@mastodon.uno
@andre123@snowfan.it
@informapirata@mastodon.uno
@informatica@feddit.it
@Pare@sociale.network
@quinta@mastodon.uno
@tecnologia@diggita.com

Società
E se tutta questa corsa alla costruzione dei data center si spiegasse con la cara, vecchia speculazione edilizia?

Chi li considera semplici capannoni. Chi li vede come mostri ecologici. Nel mezzo, chi li vede come l'ennesima occasione di far soldi. Tanti e in fretta.
di Federica Verona
10 Ottobre 2026 Per gli speculatori, una nuova tavola imbandita alla cena di gala. Tra Lombardia, Lazio e Piemonte, nei primi otto mesi dell’anno, le richieste di allacciamento a Terna – il principale operatore indipendente di reti per la trasmissione dell’energia elettrica in Europa – sono aumentate del 48 per cento, raggiungendo 95 gigawatt. Non tutti i progetti verranno realizzati, ma la pressione sui territori è evidente. Il fulcro è la corona metropolitana di Milano. Dopo essere stata investita dai capitali internazionali, aver aumentato il valore dei suoli ed espulso parte dei suoi abitanti, Milano sembra ora proiettare la stessa trasformazione verso l’esterno. I data center cercano spazio nei Comuni della cintura, tra aree dismesse, terreni meno costosi e amministrazioni attratte da oneri e compensazioni. Cambia la geografia, non il rischio: che il privato trasformi ancora una volta il territorio prima che si sia deciso collettivamente come, per chi e a quali condizioni.

#ai #ia #milano #intelligenzaartificiale #datacenter #ambiente #lombradia #speculazioneedilizia #rivistastudio

10

Caricamento...

3
12

Caricamento...

🚀Il programma sponsor per la RHC Conference 2027 è ufficialmente partito!

La RHC Conference è da sempre un appuntamento gratuito ed imperdibile per c

Altro...

🚀Il programma sponsor per la RHC Conference 2027 è ufficialmente partito!

La RHC Conference è da sempre un appuntamento gratuito ed imperdibile per chi è appassionato di , e . È l'occasione perfetta per accrescere la vostra sul rischio informatico e immergervi nel mondo dell', della e nell'intelligenza artificiale ().

📍 Pagina dell'evento: https://www.redhotcyber.com/red-hot-cyber-conference/rhc-conference-2027/?utm_source=share&utm_medium=member_desktop

Vogliamo ringraziare i primi sponsor che hanno già aderito al programma e sono Accenture italia, Ermetix, InfosecBox, S3K e Olympos Consulting.

Per qualsiasi informazioni potete scrivere a sponsor@redhotcyber.com

#cybersecurity #sicurezza #ia #innovazione #informatica #it #tecnologie #digitali #consapevolezza

0

Caricamento...

1
1

Caricamento...

ArtCraft: Software Creativi in Rust guidati dall’IA contro il monopolio Adobe, Microsoft e Autodesk

Scopriamo ArtCra

Altro...

ArtCraft: Software Creativi in Rust guidati dall’IA contro il monopolio Adobe, Microsoft e Autodesk

Scopriamo ArtCraft, la suite di software creativi e d'ufficio open source in Rust e IA. Un'alternativa nativa e veloce ai giganti del settore per liberarsi degli abbonamenti.

https://www.marcosbox.com/2026/10/11/artcraft-software-creativi-rust-ia/

@opensource@diggita.com

#opensource #ia #rust

12

Caricamento...

1
5

Caricamento...

Non una buona notizia per la . Perché il motore di ricerca tedesco molla la francese e punta alla cinese - Startma

Altro...

Non una buona notizia per la . Perché il motore di ricerca tedesco molla la francese e punta alla cinese - Startmag https://www.startmag.it/innovazione/perche-il-motore-di-ricerca-tedesco-ecosia-molla-la-francese-mistral-e-punta-allia-open-source-cinese/

@internet@diggita.com

Mistral

#opensource #ia #eu #ecosia #mistral

9

Caricamento...

0
5

Caricamento...

Non una buona notizia per la . Perché il motore di ricerca tedesco molla la francese e punta alla cinese - Startma

Altro...

Non una buona notizia per la . Perché il motore di ricerca tedesco molla la francese e punta alla cinese - Startmag https://www.startmag.it/innovazione/perche-il-motore-di-ricerca-tedesco-ecosia-molla-la-francese-mistral-e-punta-allia-open-source-cinese/

@internet@diggita.com

#opensource #ia #eu #ecosia #mistral

0

Caricamento...

0
1

Caricamento...

Windows ML abbraccia llama.cpp: modelli GGUF in locale su Windows, senza conversione ONNX

Il 7 ottobre 2026 Microsoft ha annunciato, nell’ambito della presentazione “Building for int

Altro...

Il 7 ottobre 2026 Microsoft ha annunciato, nell’ambito della presentazione “Building for intelligence”, il supporto a llama.cpp dentro Windows ML, il runtime di inferenza AI integrato in Windows 11. È una notizia che a prima vista sembra di nicchia, ma per chi sviluppa applicazioni .NET o C++ con componenti AI locali cambia un vincolo architetturale non banale: fino a ieri, per far girare un modello su Windows ML dovevi convertirlo in formato ONNX. Da oggi, in anteprima sperimentale, puoi caricare direttamente modelli — lo stesso formato usato da Ollama, LM Studio e da gran parte ’ecosistema open source che pubblica pesi quantizzati su Hugging Face — senza passare dalla pipeline di conversione.

Perché Windows ML esiste e cosa cambia con llama.cppWindows ML è diventato generalmente disponibile nel settembre 2025, distribuito a partire dalla versione 1.8.1 del Windows App SDK su Windows 11 24H2 e successivi. La sua proposta di valore è semplice da descrivere e complessa da realizzare: fare da layer di abstraction hardware tra il codice dell’app e NPU, GPU e CPU, senza che lo sviluppatore debba scrivere codice diverso per ogni fornitore di silicio.

Il meccanismo si basa su Execution Provider (EP): componenti che i partner hardware (AMD, Intel, NVIDIA, Qualcomm) costruiscono e mantengono, e che Windows ML scarica, registra e aggiorna automaticamente via Windows Update. In pratica:

AMD espone Ryzen AI tramite il Vitis AI EP, su NPU, GPU e CPU dei processori Ryzen.

Intel usa un EP basato su OpenVINO, con selezione automatica tra CPU, GPU integrata o NPU sui Core Ultra.

NVIDIA offre TensorRT for RTX, che genera motori di inferenza ottimizzati per la GPU specifica installata, con un guadagno dichiarato superiore al 50% rispetto a DirectML.

Qualcomm fornisce il Qualcomm Neural Network EP (QNN EP) per la NPU degli Snapdragon X, oltre a GPU e CPU tramite gli EP standard di ONNX Runtime.

Fino a questo annuncio, l’unico formato di modello che Windows ML sapeva eseguire era ONNX. Chi partiva da un modello PyTorch o da un checkpoint Hugging Face doveva convertirlo con l’AI Toolkit per VS Code (quantizzazione, ottimizzazione, compilazione) prima di poterlo caricare. Funziona bene per modelli di visione o per architetture stabili come ResNet, molto meno bene per l’ecosistema degli LLM open source, dove le release si susseguono settimanalmente e la community pubblica quasi sempre in GGUF, non in ONNX.

Il supporto a llama.cpp chiude questo gap: Windows ML diventa in grado di caricare GGUF nativamente, usando llama.cpp come motore di esecuzione sotto il cofano, mentre resta disponibile anche la via ONNX per i casi in cui serve il massimo controllo su quantizzazione e grafo di calcolo. Microsoft specifica che si tratta di funzionalità sperimentale (preview), insieme a un’anteprima nativa di API di inferenza Windows e a un ampliamento del supporto PyTorch e Triton, incluso su Windows Arm64. Il consiglio ufficiale è di verificare gli scenari supportati prima di usarla in produzione.

L’API di Windows ML oggi: cosa puoi già scrivereAnche in attesa che la documentazione GGUF-specifica si stabilizzi, vale la pena capire come è strutturata l’API Windows ML attuale, perché il flusso concettuale (inizializza gli EP, carica il modello, compila una volta, esegui l’inferenza) resterà probabilmente lo stesso anche per i modelli GGUF. Il punto di ingresso è il package NuGet Microsoft.WindowsAppSDK.ML, che espone sia API WinRT sia la superficie compatibile con ONNX Runtime.

Primo passo: creare l’ambiente ONNX Runtime e lasciare che Windows ML scarichi e registri gli Execution Provider certificati per l’hardware corrente.

// Crea l'ambiente ONNX Runtime con le opzioni di logging
EnvironmentCreationOptions envOptions = new()
{
logId = "DemoApp",
logLevel = OrtLoggingLevel.ORT_LOGGING_LEVEL_ERROR
};
OrtEnv ortEnv = OrtEnv.CreateInstanceWithOptions(ref envOptions);

// Windows ML individua l'hardware disponibile e scarica
// gli Execution Provider certificati per quel dispositivo
var catalog = Microsoft.Windows.AI.MachineLearning.ExecutionProviderCatalog.GetDefault();
await catalog.EnsureAndRegisterCertifiedAsync();

// Configura la policy di selezione dell'EP: qui si privilegia
// il basso consumo energetico (tipicamente la NPU, se presente)
var sessionOptions = new SessionOptions();
sessionOptions.SetEpSelectionPolicy(ExecutionProviderDevicePolicy.MIN_OVERALL_POWER);Il dettaglio interessante per chi deve gestire il deployment: gli EP non vengono inclusi nel pacchetto dell’app. Windows ML li scarica a runtime in base all’hardware rilevato, con un risparmio dichiarato “da decine a centinaia di megabyte” sulla dimensione dell’installer, e la possibilità di aggiornarli indipendentemente dall’app stessa tramite Windows Update.

Secondo passo: la compilazione del modello per l’EP scelto, un’operazione one-time per dispositivo il cui risultato viene cachato localmente:

string compiledModelPath = Path.Combine(executableFolder, "model-compiled.onnx");
bool isCompiled = File.Exists(compiledModelPath);

if (!isCompiled)
{
using var compileOptions = new OrtModelCompilationOptions(sessionOptions);
compileOptions.SetInputModelPath(modelPath);
compileOptions.SetOutputModelPath(compiledModelPath);
compileOptions.CompileModel();
isCompiled = File.Exists(compiledModelPath);
}

var modelPathToUse = isCompiled ? compiledModelPath : modelPath;Terzo passo: l’inferenza vera e propria, con la stessa API InferenceSession familiare a chi ha già usato ONNX Runtime in altri contesti (server, Azure Functions, desktop):

using var session = new InferenceSession(modelPathToUse, sessionOptions);

var inputName = session.InputMetadata.First().Key;
var inputTensor = new DenseTensor(inputData, new[] { 1, 3, 224, 224 }, false);

var inputs = new List
{
NamedOnnxValue.CreateFromTensor(inputName, inputTensor)
};

var results = session.Run(inputs);
var outputName = session.OutputMetadata.First().Key;
var outputTensor = results.First(r => r.Name == outputName).AsEnumerable().ToArray();Chi preferisce C++ trova un’API praticamente equivalente (Ort::ModelCompilationOptions, Ort::Session, Ort::Value), utile se il tuo progetto è già un’app WinRT/C++ nativa. Con il supporto llama.cpp, l’aspettativa ragionevole — in base a come Microsoft ha descritto l’integrazione — è che il caricamento di un file .gguf si inserisca in questo stesso flusso come alternativa al passaggio di conversione ONNX, piuttosto che richiedere un’API completamente separata.

Cosa significa in pratica per chi sviluppa su WindowsIl contesto in cui arriva questo annuncio non è casuale. Microsoft lo inquadra dentro una strategia più ampia di “hybrid intelligence”: Copilot su Windows comincia a combinare modelli cloud e modelli locali in base al task, e i PC Copilot+ eseguono già, secondo i dati citati da Microsoft, oltre 2.000 miliardi di inferenze locali al mese. L’apertura a llama.cpp e GGUF è il tassello che permette a chi sviluppa con questi strumenti open source — già oggi lo standard de facto per far girare LLM in locale su CPU/GPU consumer — di appoggiarsi all’infrastruttura di distribuzione e accelerazione hardware di Windows ML, invece di gestire manualmente binari di llama.cpp compilati per ogni combinazione di GPU e driver.

Per un team che oggi distribuisce un’app con un modello locale integrato tramite llama.cpp “nudo”, i vantaggi concreti del passaggio a Windows ML sono essenzialmente tre: non devi più compilare e distribuire build separate di llama.cpp per NVIDIA, AMD, Intel e Qualcomm; gli aggiornamenti delle accelerazioni hardware arrivano via Windows Update senza una nuova release della tua app; e la selezione dell’EP (NPU per basso consumo, GPU per throughput, CPU come fallback universale) diventa una policy dichiarativa (ExecutionProviderDevicePolicy) invece di logica scritta a mano per rilevare l’hardware.

Il rovescio della medaglia, va detto con chiarezza vista la natura “experimental” della feature: prima di spostare un prodotto in produzione su questa via, conviene verificare quali modelli GGUF e quali quantizzazioni sono effettivamente supportate oggi, dato che Microsoft stessa invita alla cautela. Per prototipi, tool interni e applicazioni che già puntano su Windows 11 24H2+, è però un buon momento per iniziare a sperimentare: la direzione — portare l’ecosistema open source dei modelli locali dentro un runtime gestito e accelerato dal sistema operativo — sembra ormai una scelta strategica di lungo periodo da parte di Microsoft, non un esperimento isolato.

Per iniziareChi vuole provare da subito Windows ML con i modelli ONNX esistenti può partire dal repository ufficiale WindowsAppSDK-Samples, che contiene il progetto completo usato come riferimento in questo articolo, e dalla AI Toolkit per VS Code per la conversione di modelli PyTorch. Per il supporto GGUF/llama.cpp, essendo ancora in fase sperimentale, la raccomandazione è monitorare la documentazione ufficiale su Microsoft Learn prima di integrarlo in un progetto destinato alla produzione.

Fonte: Windows Blog — “Building Windows for hybrid intelligence”, 7 ottobre 2026; documentazione tecnica su Microsoft Learn — Windows ML overview.

#ai #ia #windows #c #howto #net #machinelearning #gguf #llamacpp #windowsml

0

Caricamento...

0
2

Caricamento...

AgentCorruption: come un prompt poteva compromettere tutti gli agenti AWS Bedrock AgentCore di una regione

Un prompt, tutti gli agenti di una regioneL’8 ottobre 2026, in concomitanza con una presentazione al SecTor 2026 di Toronto, i ricercatori di Zenity L

Altro...

Un prompt, tutti gli agenti di una regioneL’8 ottobre 2026, in concomitanza con una presentazione al SecTor 2026 di Toronto, i ricercatori di Zenity Labs hanno divulgato pubblicamente AgentCorruption: una catena di vulnerabilità in Amazon Bedrock AgentCore, il servizio gestito con cui permette di distribuire ed eseguire agenti AI in produzione. Il risultato dimostrato dai ricercatori è di quelli che dovrebbero far riflettere chiunque stia costruendo (o valutando di costruire) agenti autonomi su infrastrutture : partendo da un singolo prompt dannoso inviato a un agente esposto pubblicamente — ad esempio un chatbot di supporto clienti — è stato possibile ottenere il controllo di tutti gli altri agenti AgentCore dello stesso account e della stessa regione AWS, inclusi quelli interni e più sensibili.

Il problema è stato segnalato ad AWS in modo responsabile il 25 dicembre 2025 e corretto prima della divulgazione pubblica; non risultano exploit osservati “in the wild”. Ma il meccanismo ’attacco merita di essere capito in dettaglio, perché illustra un rischio strutturale che va ben oltre il singolo bug e riguarda qualsiasi piattaforma di agenti gestita.

La catena d’attacco, passo per passo1. Dal prompt injection all’Instance Metadata ServiceIl punto di ingresso è una tecnica ormai familiare: un agente pubblico, dotato di un normale strumento per effettuare richieste HTTP in uscita (ad esempio per consultare una base di conoscenza esterna), viene istruito via prompt a effettuare una richiesta verso l’endpoint dell’Instance Metadata Service (IMDS) della macchina sottostante — lo stesso endpoint, raggiungibile tipicamente su 169.254.169.254, che su EC2 restituisce credenziali temporanee legate al ruolo IAM dell’istanza:

GET http://169.254.169.254/latest/meta-data/iam/security-credentials/Secondo Zenity, l’agente gira all’interno di una microVM basata su Firecracker priva del necessario isolamento di rete verso questo endpoint: qualsiasi agente in grado di effettuare richieste HTTP in uscita può quindi raggiungere IMDS e farsi restituire le credenziali temporanee del ruolo di esecuzione sottostante, senza bisogno di altre vulnerabilità applicative.

  1. “One Role to Rule Them All”: il ruolo IAM condivisoIl vero amplificatore del danno non è l’accesso a IMDS in sé, ma cosa quelle credenziali permettevano di fare. Il ruolo IAM predefinito usato dagli agenti AgentCore non era circoscritto al singolo agente, ma copriva le risorse AgentCore dell’intera regione AWS: con quelle credenziali i ricercatori hanno potuto enumerare ed invocare altri agenti nello stesso account, leggere le loro sessioni attive e accedere a segreti archiviati in AWS Secrets Manager e nelle variabili d’ambiente di altri agenti — comprese chiavi API e token OAuth usati per integrazioni con servizi aziendali e di terze parti.

È lo stesso antipattern che si incontra fin troppo spesso nelle configurazioni IAM “provvisorie”: un ruolo ampio creato per far funzionare rapidamente un servizio, mai più ristretto in un secondo momento. Qui l’impatto è amplificato dal fatto che il ruolo non apparteneva a un singolo workload, ma era condiviso implicitamente da ogni agente della regione.

  1. Movimento laterale e furto del codice sorgenteDa lì la catena si allarga ulteriormente: i ricercatori hanno potuto scaricare e leggere le immagini degli altri agenti, recuperandone di fatto il codice sorgente, e muoversi lateralmente tra agenti interni e pubblici fino a raggiungere, in teoria, credenziali con privilegi più ampi all’interno dell’organizzazione.

  2. Memory poisoning: la persistenza silenziosaL’aspetto forse più insidioso della ricerca è la dimostrazione di un attacco di memory poisoning: modificando la memoria a lungo termine di un agente, i ricercatori hanno inserito istruzioni persistenti che continuavano a inoltrare le conversazioni future a una destinazione controllata dall’attaccante, anche dopo che l’accesso iniziale sarebbe stato chiuso. È un promemoria del fatto che, per gli agenti AI, la “memoria” è una superficie di attacco a sé, separata dal runtime e dalle credenziali, e va trattata con lo stesso rigore di un database che contiene dati utente.

La risposta di AWSSecondo le verifiche di Zenity Labs, AWS ha corretto i problemi principali prima della divulgazione pubblica:

i nuovi deployment di AgentCore usano ora IMDSv2 come impostazione predefinita, che richiede un token di sessione ottenuto con una richiesta PUT autenticata e rende quindi molto più difficile lo sfruttamento da semplice SSRF/prompt injection;

il ruolo di esecuzione predefinito è stato ridotto, rimuovendo la capacità di invocare altri agenti, leggere le conversazioni private di altri agenti e accedere indiscriminatamente a Secrets Manager.

Non è stato pubblicato (almeno nelle fonti disponibili al momento della scrittura) un identificativo specifico per questa catena, a differenza di altri problemi correlati su AgentCore — come le falle nel SDK Starter Toolkit legate a code injection e SSRF, che hanno invece ricevuto CVE distinti — e come il caso, segnalato separatamente da BeyondTrust, di un bypass nella modalità “sandbox isolata” del Code Interpreter di AgentCore (CVSS 7.5), che dimostra come la famiglia di problemi legati all’isolamento di rete degli agenti non sia un caso isolato.

Cosa portare a casa, anche se non usi AgentCoreLe lezioni di AgentCorruption si applicano a qualsiasi piattaforma agentica, gestita o self-hosted:

Imposta sempre IMDSv2 su ogni istanza EC2 o ambiente di esecuzione che possa ospitare codice non completamente attendibile (agenti, plugin, codice generato da LLM). Verificalo esplicitamente, non assumerlo:
aws ec2 describe-instances --query
"Reservations[].Instances[].MetadataOptions"

Un ruolo IAM per agente, non un ruolo per servizio. Ogni agente dovrebbe avere un ruolo di esecuzione limitato esclusivamente alle risorse che gli servono, senza possibilità di enumerare o invocare altri agenti dello stesso account. In pratica: niente wildcard su bedrock-agentcore:* a livello di account o regione.

Non esporre agenti privilegiati direttamente al pubblico senza un livello di validazione dell’input e senza aver ridotto al minimo ciò che quell’agente specifico può raggiungere a valle, anche in caso di compromissione totale.

Tratta la memoria dell’agente come dato non attendibile. Se un agente scrive nella propria memoria a lungo termine informazioni derivate da input esterni (utenti, documenti, risposte di altri tool), quella memoria può essere avvelenata esattamente come un database esposto a input utente non sanificato.

Instrumenta per il rilevamento, non solo per la prevenzione. Credenziali “canary” nel ruolo IAM, percorsi S3 esca e DNS sinkhole sono tecniche di deception che permettono di scoprire rapidamente se un agente è stato compromesso, anche quando la prevenzione fallisce.

ConclusioneAgentCorruption non è una falla esotica: è la combinazione, fin troppo comune, di una configurazione IAM troppo permissiva e di un confine di rete meno isolato di quanto documentato. La differenza, con gli agenti AI, è che il punto di ingresso non richiede più un exploit tecnico: basta un prompt. Per chi progetta sistemi agentici, il principio del minimo privilegio applicato per-agente, non per-servizio, passa da “buona pratica” a requisito di sicurezza di base.

Fonti: Dark Reading – “AgentCorruption Puts AWS Environments At Risk With One Prompt”, Zenity Labs e CSO Online.

#sicurezza #ai #ia #cloud #aws

0

Caricamento...

0
3

Caricamento...

🌻Girasoli viola giganti, angurie blu, fiori con la faccia da gatto, perfino semi di "gamberi demoniaci che urlano".
👉 https://www.youtube.com/watch?v

Altro...

🌻Girasoli viola giganti, angurie blu, fiori con la faccia da gatto, perfino semi di "gamberi demoniaci che urlano".
👉 https://www.youtube.com/watch?v=F2pKfeZpVpk

Su Amazon, eBay ed Etsy si vendono a prezzi minimi, con foto impeccabili, e li ordinano in migliaia.
E poi cresce un fiore qualsiasi, se cresce.

Il punto è la frizione tra promessa implicita e realtà. La piattaforma fatica a distinguere tra una foto autentica di un ibrido raro e un'immagine sintetica di una pianta che non esiste in natura. E l'IA generativa diventa lo strumento ideale per produrre "prove" visive convincenti, a costo quasi nullo, ricaricabili all'infinito quando gli annunci vengono rimossi.

Il meccanismo scala facilmente e prepara il terreno a versioni più costose, dai corsi miracolosi agli investimenti. Cambia l'oggetto venduto ma resta la stessa macchina che monetizza credulità, ambiguità e immagini perfette.

Ne parliamo nella puntata di oggi, su Ciao Internet

#ia #amazon #etsy #aislop #truffeonline #ecommerce

600

Caricamento...

0
4

Caricamento...

Cloudflare cf: la CLI agentica che sostituisce Wrangler con 3.000 operazioni API

Wrangler non basta più: nasce cf, la CLI pensata prima per gli agenti che per gli umaniIl 28 settembre 2026 ha rilasciato in open beta cf,

Altro...

Wrangler non basta più: nasce cf, la CLI pensata prima per gli agenti che per gli umaniIl 28 settembre 2026 ha rilasciato in open beta cf, una nuova interfaccia a riga di comando che sostituisce (o meglio, affianca durante la transizione) Wrangler, lo strumento storico usato per gestire Workers, Pages e l’infrastruttura Cloudflare. La differenza numerica è già indicativa della portata del cambiamento: se Wrangler copre circa 280 comandi costruiti a mano nel corso degli anni da team diversi, cf espone oltre 3.000 operazioni, generate automaticamente a partire dagli schemi OpenAPI che già alimentano la documentazione ufficiale e gli SDK.

Per chi amministra infrastrutture su Cloudflare — , Workers, R2, D1, Zero Trust — questa non è solo un’estensione della superficie di comando: è un cambio di filosofia dichiarato apertamente dal team, che nel post di annuncio scrive che “gli agenti hanno bisogno di JSON, e se gli agenti sono destinati a diventare gli utenti primari di questo strumento, JSON deve essere il formato predefinito”.

La pipeline Forge: come nascono 3.000 comandi senza impazzireIl motore dietro cf si chiama Forge, una pipeline di generazione che Cloudflare ha reso open source e che converte gli schemi OpenAPI in comandi CLI con un’annotazione minima aggiuntiva. È lo stesso principio con cui oggi vengono generati gli SDK ufficiali e la documentazione API: unificando la fonte di verità, Cloudflare ha potuto standardizzare comandi storicamente incoerenti tra team diversi e, allo stesso tempo, ampliare drasticamente la copertura dell’API.

Il risultato pratico più citato nel post ufficiale è la riduzione della complessità di configurazione: alcuni file Wrangler usati internamente da Cloudflare, che superavano le 5.000 righe, si sono ridotti del 40% passando al nuovo formato.

Installazione e primi comandiL’installazione avviene via npm, come per Wrangler:

npm i -g cf
I comandi principali per iniziare un progetto ricalcano un flusso familiare:

Avvia un nuovo progetto Hello World

cf init

Effettua il deploy di siti statici o Worker

cf deploy

Converte un progetto Wrangler esistente

cf migrate
La novità più interessante per chi lavora con agenti AI è cf cli search, un comando pensato per la scoperta in linguaggio naturale tra le oltre 3.000 operazioni disponibili: invece di dover ricordare a memoria (o far ricordare al modello) migliaia di sottocomandi, l’agente interroga cf cli search con una descrizione dell’obiettivo e riceve indicazioni mirate, senza dover caricare nel contesto l’intero elenco dei comandi disponibili — un dettaglio non banale quando si lavora con finestre di contesto limitate.

Configurazione TypeScript al posto del TOMLUn cambiamento che avrà un impatto diretto sul lavoro quotidiano degli sviluppatori è l’abbandono del formato TOML di Wrangler in favore di file cloudflare.config.ts scritti in , con type-checking e supporto LSP nativo nell’editor:

import { defineConfig, bindings, triggers } from "cf/config";

export default defineConfig({
name: "my-worker",
bindings: bindings({
kv: "MY_KV_NAMESPACE",
d1: "MY_DATABASE",
r2: "MY_BUCKET",
}),
triggers: triggers({
fetch: true,
scheduled: "0 */6 * * *",
}),
});
L’helper bindings fornisce il completamento automatico per variabili d’ambiente, storage KV, database D1, bucket R2, code (Queues) e i binding worker-to-worker, mentre triggers consolida in un unico punto i trigger di tipo fetch, scheduled, queue ed email. Per un team che gestisce decine di Worker, il vantaggio del type-checking in fase di scrittura — piuttosto che scoprire un errore di configurazione solo al deploy — non è un dettaglio marginale.

Vite al posto di esbuildUn’altra scelta tecnica degna di nota è l’adozione di Vite come build system predefinito, al posto di esbuild usato da Wrangler. Questo porta hot module replacement e un ecosistema di plugin più maturo per chi sviluppa applicazioni complesse su Workers, anche se i progetti JavaScript Workers che già usano configurazioni esbuild personalizzate continueranno temporaneamente a delegare a Wrangler durante la fase di transizione.

Perché JSON-first cambia le regole del giocoDal punto di vista di un sistemista abituato a Wrangler, uno dei cambiamenti più tangibili riguarda l’output dei comandi. Wrangler restituiva tabelle Unicode pensate per la lettura umana, che spesso richiedevano il filtraggio con jq per essere processate in script di automazione. cf inverte la priorità: l’output è JSON per default (con pretty-print quando il terminale è interattivo), pensato in primo luogo per il consumo programmatico da parte di agenti e pipeline CI/CD, e solo secondariamente per la lettura diretta.

Per le operazioni complesse — l’esempio citato nel post ufficiale è l’acquisto di un dominio, che richiede numerosi parametri interdipendenti — cf scompone il flusso in input sequenziali validati, mantenendo la possibilità di eseguirlo sia in modalità interattiva (per un umano) sia in modalità completamente programmatica (per uno script o un agente).

Roadmap di migrazione da WranglerCloudflare ha dichiarato che Wrangler riceverà supporto di manutenzione per 18 mesi dopo la fine della fase beta di cf, un periodo di transizione sufficientemente ampio per pianificare la migrazione senza fretta. Il comando cf migrate automatizza la conversione dei progetti esistenti, ma vale la pena, prima di lanciarlo su repository di produzione, verificare manualmente i binding e i trigger generati, specialmente per configurazioni Wrangler complesse costruite nel tempo da più persone.

ConclusioneIl lancio di cf segna un punto di svolta interessante per chi gestisce infrastruttura su Cloudflare: non è semplicemente “Wrangler con più comandi”, ma una CLI ripensata da zero attorno all’idea che l’utente principale, in un futuro ormai prossimo, sarà un agente AI e non una persona davanti al terminale. Per i team italiani che già usano Cloudflare per Workers, DNS o Zero Trust, vale la pena iniziare a sperimentare cf in ambienti di test non appena possibile: la finestra di 18 mesi di coesistenza con Wrangler è generosa, ma la configurazione TypeScript e l’output JSON-first sono vantaggi concreti anche per chi non ancora agenti AI nella propria toolchain quotidiana.

Fonte: Cloudflare Blog – Introducing cf: the agentic CLI for the entire Cloudflare API.

#ai #ia #devops #howto #cloudflare #dev

0

Caricamento...

0
1

Caricamento...

Agenti IA di OpenAI avrebbero interrogato oltre 16.000 volte un portale dati ONU, aggirando filtri e limiti di accesso. OpenAI sta esaminando il caso e avviando una revisione sui comportamenti

impropri dei modelli. @sicurezza [https://za.investing.com/news/company-news/openai-agents-aggressively-accessed-un-data-

Altro...

impropri dei modelli. @sicurezza https://za.investing.com/news/company-news/openai-agents-aggressively-accessed-un-data-website-more-than-16000-times-4479235?utm%5C_source=perplexity

#cybersecurity #ia #aiethics

1

Caricamento...

0
3

Caricamento...

Da 430.000 righe di TypeScript a Rust: GitHub ha usato agenti AI per riscrivere il runtime di Copilot

Riscrivere da zero il runtime che alimenta CLI, SDK e integrazioni di (in VS Code, Visual Studio, E

Altro...

Riscrivere da zero il runtime che alimenta CLI, SDK e integrazioni di (in VS Code, Visual Studio, Excel, Outlook, PowerPoint, ) è il tipo di progetto che, in condizioni normali, nessun team ingegneristico si permetterebbe di avviare: centinaia di migliaia di righe di codice in produzione, usate da milioni di sviluppatori, da portare da un linguaggio a un altro senza fermare la nave. GitHub lo ha fatto lo stesso, usando agenti AI per eseguire gran parte del lavoro, e ha pubblicato un resoconto tecnico dettagliato dell’operazione: circa 430.000 righe di convertite in oltre 830.000 righe di , per un costo in token AI di circa 120.000 dollari e tre settimane di lavoro umano concentrato, distribuite su un progetto durato da metà maggio a fine agosto 2026.

Perché Rust, e perché oraIl runtime agentico di Copilot girava su Node.js/V8: ogni consumer dell’SDK (che fosse la CLI, un plugin IDE o un’integrazione Office) doveva avviare un sottoprocesso e comunicare via JSON-RPC su pipe o socket, pagando un overhead minimo di circa 100 MB di memoria solo per l’avvio della VM V8, oltre alla latenza di marshalling tra processi. Portare il runtime in Rust ed esporlo tramite una C ABI nativa elimina questo overhead: sei linguaggi SDK (C#, Go, , Python, Rust, TypeScript) possono ora ospitare il runtime in-process, tramite bridge nativi diversi per ciascun linguaggio (P/Invoke per C#, purego per Go, JNA per Java, cffi per Python, libloading per Rust, koffi per TypeScript), mantenendo lo stesso protocollo JSON-RPC internamente per non dover duplicare l’intera superficie API (364 route di dispatch) per ciascun linguaggio.

Il risultato più citato è un miglioramento di 15,9 volte su un workload specifico, oltre a un consumo di memoria drasticamente ridotto grazie all’eliminazione dell’overhead V8. Ma il dato più interessante per chi valuta operazioni simili non è il benchmark finale, bensì il come ci sono arrivati.

Metodologia: sostituzione atomica, non big-bangInvece di congelare lo sviluppo per una riscrittura monolitica, il team ha adottato una strategia di sostituzione atomica componente per componente: ogni pezzo di TypeScript portato in Rust veniva sostituito da un thin shim che richiamava il nuovo codice nativo, con il vecchio codice cancellato nello stesso commit. Questo ha permesso di continuare a rilasciare regolarmente durante tutta la migrazione: 135 in 14,5 settimane, una media di 1,3 release al giorno, con il 10,5% dei download instradati su canali pre-release per validazione reale prima della promozione a stable.

Il lavoro è proceduto “dalle foglie verso il centro”: prima le utility pure e le funzioni di I/O, poi i sottosistemi stateful, infine l’orchestrazione. Il singolo PR più corposo ha toccato oltre 99.000 righe modificate, concentrato nella fase finale quando la migrazione ha raggiunto i sottosistemi più interconnessi.

Come sono stati orchestrati gli agentiUn solo sviluppatore ha supervisionato l’operazione, coordinando “decine di sviluppatori assistiti da agenti” che univano centinaia di pull request a settimana. La struttura tipica prevedeva sessioni primarie che coordinavano il lavoro, sessioni figlie per porzioni parallele (fino a 15 simultanee) e subagent per compiti di esplorazione mirata (explore, code-review, rubber-duck).

Un esempio citato nel post: la porting del file session.ts (30.000 righe) ha richiesto 25 ore, generando 15 sessioni figlie in sette ondate più cinque subagent, con la sessione padre che ha effettuato 60 poll di stato e inviato 89 messaggi di coordinamento prima di fare cherry-pick e risolvere i conflitti.

Un problema emerso presto: 15 agenti che tentano build simultanee sullo stesso laptop generano stalli da contesa di risorse. La soluzione adottata è stata una sessione di chat dedicata che agisce da “mutex agentico”, concedendo lease di build esclusivi tramite messaggistica cross-session — un pattern di ingegneria distribuita applicato alla gestione di agenti AI concorrenti, non troppo diverso da un lock manager in un sistema distribuito tradizionale.

Testing e code review a scalaLa superficie di test generata è imponente: 468.689 unit test in Rust e 174.675 test end-to-end in TypeScript, con ogni PR di porting validato contro l’intera suite E2E esistente. Un ruolo cruciale lo ha giocato una skill custom chiamata rust-rebase-review, che eseguiva un confronto comportamentale riga-per-riga tra TypeScript e Rust usando più subagent, uno per modello (Opus, GPT-5.6 Sol, Grok 4.6), oltre a normalizzare lo stile Rust (uso di memchr per le ricerche, composizione di trait, riduzione di allocazioni superflue).

Su ogni commit giravano cargo check, cargo test, cargo clippy, cargo fmt e controlli di compatibilità degli schemi. Un dato che ridimensiona un pregiudizio comune su Rust: degli 8.678 errori del compilatore osservati durante il porting, solo l’1,7% era legato al borrow checker — la parte di Rust che genera più discussioni si è rivelata “una presenza silenziosa sullo sfondo”, mentre il grosso degli errori (37%) riguardava semplice risoluzione di nomi e import.

Le regressioni: dove il codice generato dagli agenti ha fallitoIl resoconto è onesto nel documentare le decine di regressioni introdotte durante il porting, categorizzate per tipologia:

Semantica ambigua (~20%): il tipo number implicito di TypeScript, una volta reso esplicito come f64/i64 in Rust, ha causato mismatch di serializzazione (es. 42.0 contro 42)

Comportamenti ambientali (~25%): fuso orario, variabili d’ambiente, working directory e identità del repository che in TypeScript venivano catturati implicitamente prima del porting

Desincronizzazione di operazioni accoppiate (~15%): aggiornamenti di registro senza la relativa cancellazione, stato di task completato ma non propagato nella sessione

Blocco del thread principale (~10%): export napi sincroni che congelavano la UI, risolti rendendo gli export asincroni con offload su thread pool

Problemi lifecycle/ownership (~15%): handle opachi in TypeScript che sopravvivevano alle istanze Rust corrispondenti, hook di dispose che orfanizzavano blocchi di modello

Ogni regressione risolta è stata reincorporata nelle istruzioni standing e nei prompt di Copilot per prevenirne la ricorrenza — un ciclo di feedback che vale la pena replicare in qualsiasi pipeline agentica su larga scala.

Lezioni per chi valuta un’operazione simileAl netto dei numeri, il post di GitHub offre alcune indicazioni pratiche per team che considerano l’uso di agenti AI su refactoring o migrazioni massicce:

Serve intento esplicito: dare nomi diversi a sessioni concorrenti non impedisce tentativi di orchestrazione indesiderata; i confini vanno vietati esplicitamente nei prompt.

Le capacità disponibili vengono usate: aver reso disponibile una skill di orchestrazione ha portato gli agenti a scoprirla e applicarla anche fuori dall’ambito previsto.

Il coordinamento tra pari richiede un arbitro: due sessioni autonome su lavoro adiacente necessitano di un coordinatore designato o di arbitraggio umano.

Lo scope dell’esecuzione autonoma va delimitato con precisione: istruzioni generiche come “non svegliarmi per dettagli” sono state interpretate in modo estensivo, includendo l’annessione unilaterale di lavoro altrui.

Il giudizio umano resta indispensabile per definire i problemi, tracciare i confini, scegliere le strategie e arbitrare le eccezioni: gli agenti hanno gestito l’esecuzione, ma la responsabilità architetturale è rimasta umana.

Un altro dato che ridimensiona l’idea di “riscrittura automatica”: del corpus di 12,76 milioni di eventi raccolti durante il progetto, solo circa 2.600 messaggi erano effettivamente scritti da umani (il resto erano istruzioni di skill, merge automatici e traffico cross-session/subagent). Di questi messaggi umani, il 31% riguardava review, testing e CI, e il 17% consisteva nel mettere in discussione decisioni tecniche o architetturali proposte dagli agenti — a conferma che il ruolo umano si è spostato dalla scrittura di codice alla supervisione critica del lavoro agentico.

Per i team .NET, Java o Python che integrano Copilot SDK, il beneficio pratico è concreto: l’hosting in-process tramite C ABI riduce l’overhead di memoria e latenza rispetto al precedente modello a sottoprocesso, senza richiedere modifiche al codice applicativo che consuma l’SDK.

Fonte originale: The GitHub Blog
#ai #ia #github #rust #copilot #machinelearning

0

Caricamento...

0
2

Caricamento...

RE: https://mastodon.uno/@valigiablu/117275898110852440

Le IA sterminerà il genere umano: rischi veri o allarmismo a comando per attirare l'attenzion

Altro...

RE: https://mastodon.uno/@valigiablu/117275898110852440

Le IA sterminerà il genere umano: rischi veri o allarmismo a comando per attirare l'attenzione di tutti?

Qua una buon sintesi rilanciata nel nostro gruppo tecnologia seguibile da qui: @tecnologia@diggita.com

#ai #ia #intelligenzaartificiale

🧵 L’intelligenza artificiale ci ucciderà tutti? La risposta è "NI": dipende da quanto siamo stupidi noi

Una buona sintesi-spiegone di Alessio Jacona.

Altro...

🧵 L’intelligenza artificiale ci ucciderà tutti? La risposta è "NI": dipende da quanto siamo stupidi noi

Una buona sintesi-spiegone di Alessio Jacona.

#ai #openai #anthropic #amodei

18

Caricamento...

2
12

Caricamento...